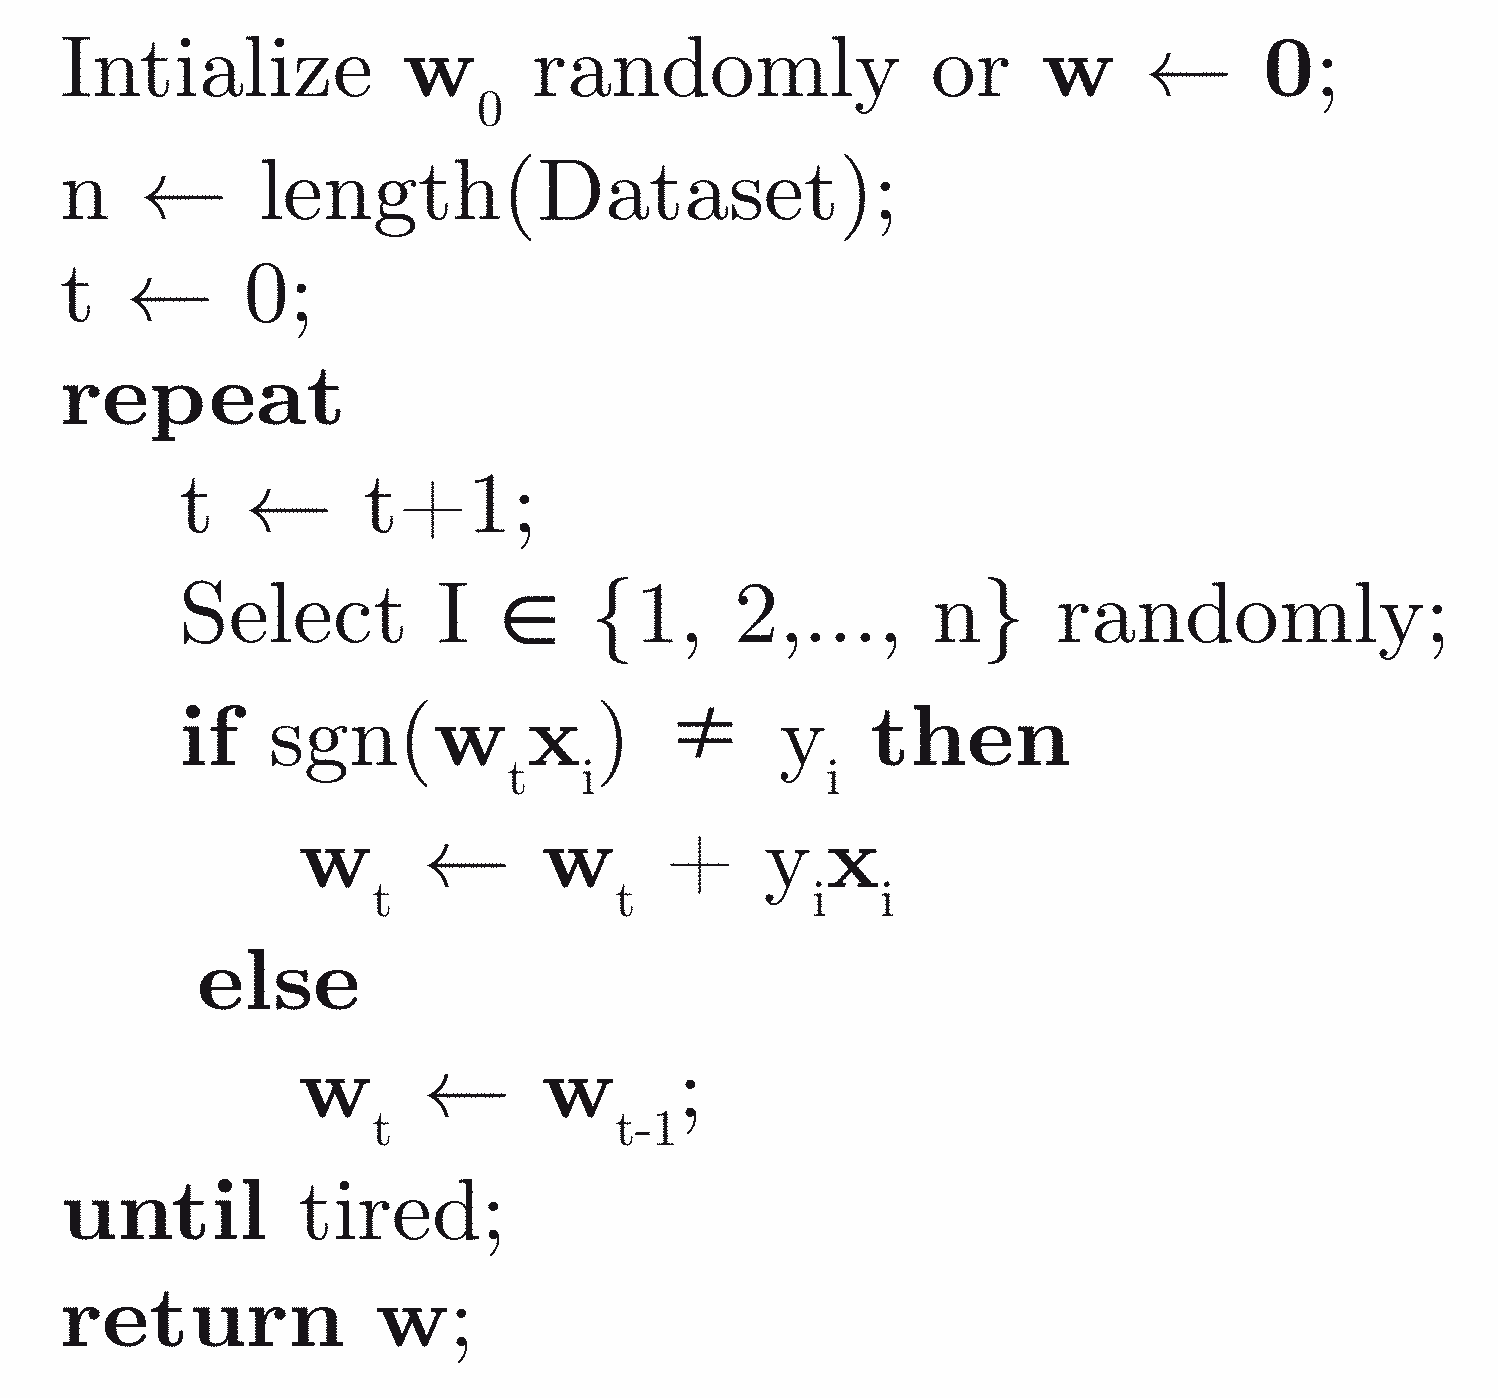<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" ><generator uri="https://jekyllrb.com/" version="4.4.1">Jekyll</generator><link href="https://nhat.codeberg.page/essays/feed.xml" rel="self" type="application/atom+xml" /><link href="https://nhat.codeberg.page/essays/" rel="alternate" type="text/html" /><updated>2026-09-16T16:51:10+07:00</updated><id>https://nhat.codeberg.page/essays/feed.xml</id><title type="html">nhatism</title><subtitle></subtitle><author><name>nhatism</name></author><entry><title type="html">Thử nhúng watermark vào văn bản</title><link href="https://nhat.codeberg.page/essays/watermark.html" rel="alternate" type="text/html" title="Thử nhúng watermark vào văn bản" /><published>2026-09-14T00:00:00+07:00</published><updated>2026-09-14T00:00:00+07:00</updated><id>https://nhat.codeberg.page/essays/watermark.html</id><content type="html" xml:base="https://nhat.codeberg.page/essays/watermark.html"><![CDATA[<blockquote>
  <p>The first lot fell to Jehoiarib, the second to Jedaiah, the third to Harim, […] and the twenty-fourth to Maaziah.</p>

  <p>— 1 Chronicles 24:7–19</p>
</blockquote>

<p>Các công ty AI đang rục rịch nhét watermark vào văn bản. Gay cấn hơn, họ có lẽ sẽ bán detector cho trường học, tạp chí, những nơi đang combat với AI-generated content. Nghĩa là họ tạo ra những con dấu vô hình (lẫn tình), rồi đưa cho người khác một cái máy dò dấu bị giấu. Chuyến này các vibe scientist như tôi lành ít dữ nhiều… Nghe đâu mỗi hãng có “một công thức bí mật,” thành ra tôi không rõ watermark kiểu này hoạt động thế nào, nên thôi thì thử làm một cái.</p>

<p>Ta chọn một câu đơn giản, và thay đổi nó sao cho người đọc không nhận ra, nhưng một chương trình có thể nhận ra sau này:</p>

<blockquote>
  <p>We postponed the launch because the database failed overnight.</p>
</blockquote>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">TEXT</span> <span class="o">=</span> <span class="sh">"</span><span class="s">We postponed the launch because the database failed overnight.</span><span class="sh">"</span>
<span class="n">MARK</span> <span class="o">=</span> <span class="sh">"</span><span class="se">\u200b</span><span class="sh">"</span>
<span class="n">marked</span> <span class="o">=</span> <span class="n">TEXT</span> <span class="o">+</span> <span class="n">MARK</span>

<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">human sees:    </span><span class="sh">"</span><span class="p">,</span> <span class="n">marked</span><span class="p">)</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">detector sees:</span><span class="sh">"</span><span class="p">,</span> <span class="n">MARK</span> <span class="ow">in</span> <span class="n">marked</span><span class="p">)</span>
</code></pre></div></div>
<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>human sees:    We postponed the launch because the database failed overnight.​
detector sees: True
</code></pre></div></div>

<p>Easy. Cho đến khi ta thử tiện tay làm đẹp một tí theo nguyên tắc you get what you see, giữ lại phần plaintext có thể hiển thị:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">cleaned</span> <span class="o">=</span> <span class="sh">""</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">c</span> <span class="k">for</span> <span class="n">c</span> <span class="ow">in</span> <span class="n">marked</span> <span class="k">if</span> <span class="n">c</span><span class="p">.</span><span class="nf">isprintable</span><span class="p">())</span>
<span class="nf">print</span><span class="p">(</span><span class="sh">"</span><span class="s">detector sees after:</span><span class="sh">"</span><span class="p">,</span> <span class="n">MARK</span> <span class="ow">in</span> <span class="n">cleaned</span><span class="p">)</span>
</code></pre></div></div>
<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>detector sees after: False
</code></pre></div></div>

<p>Hình dung ta có một tấm kính trong suốt được dán decal, rồi đổ một ít nước lên mặt kính. Nhìn nghiêng, ta nhận ra lớp nước đang ở đó. Nhưng khi rọi ánh sáng qua kính và nhìn bóng trên tường, thứ hiện rõ là bóng của decal; còn nước không để lại dấu vết gì.</p>

<p>Zero-width character tồn tại trong văn bản và detector bắt được. Nhưng sau khi câu văn đi qua một representation chỉ giữ phần plaintext hiển thị, thì marker coi như mất. Thậm chí còn chả buồn biết vị trí của watermark để phá. Ta vô tình encode dấu vết vào nước, trong khi thứ detector nhận ở bước tiếp theo là cái bóng. Thế là 404.</p>

<p>Cách giấu watermark này thất bại không hẳn vì detector ngu, mà vì ta đang cược khả năng phát hiện vào một vật thể lạ được <em>chèn</em> vào text. Một dấu vết có mặt trong văn bản gốc không đảm bảo nó sẽ tồn tại trong các hình thức biểu diễn khác của văn bản.</p>

<hr />

<h1 id="take-2-can-thiệp-vào-quá-trinh-sinh-text">Take 2: Can thiệp vào quá trinh sinh text</h1>

<p>Để ý một câu văn chứa nhiều lựa chọn. Ta có thể chọn sao cho ngữ nghĩa ổn định, trong khi bề mặt có thể biến hóa khôn lường:</p>

<blockquote>
  <p>We postponed the launch because the database failed overnight.</p>
</blockquote>

<ul>
  <li><code class="language-plaintext highlighter-rouge">postponed</code> hay <code class="language-plaintext highlighter-rouge">delayed</code>;</li>
  <li><code class="language-plaintext highlighter-rouge">because</code> hay <code class="language-plaintext highlighter-rouge">after</code>;</li>
  <li><code class="language-plaintext highlighter-rouge">the database failed</code> hay <code class="language-plaintext highlighter-rouge">database went down</code>.</li>
</ul>

<p>Thay vì chèn ký tự mới để detector tìm, ta có thể dùng chính <strong>những lựa chọn xảy ra khi câu được viết</strong> không? Giả sử ở một vị trí, model đang cân nhắc bốn chữ: postponed, delayed, deferred, moved. Bốn chữ này khác nhau, và Anthropic cũng chả ưa chúng nó như nhau. Nhưng cả bốn đều có một xác suất nào đó được chọn, ta thử biểu diễn bằng một phân phối xác suất (classic Nhatism Distribution):</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">weights</span> <span class="o">=</span> <span class="p">{</span>
    <span class="sh">"</span><span class="s">postponed</span><span class="sh">"</span><span class="p">:</span> <span class="p">.</span><span class="mi">40</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">delayed</span><span class="sh">"</span><span class="p">:</span>   <span class="p">.</span><span class="mi">30</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">deferred</span><span class="sh">"</span><span class="p">:</span>  <span class="p">.</span><span class="mi">20</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">moved</span><span class="sh">"</span><span class="p">:</span>     <span class="p">.</span><span class="mi">10</span><span class="p">,</span>
<span class="p">}</span>
</code></pre></div></div>

<p>Để ý nhé, đây chính là cục xúc xắc mà bạn đã học ở trường, có điều các mặt có khả năng xuất hiện khác nhau. <code class="language-plaintext highlighter-rouge">"postponed"</code> vốn là chữ nghe thuận tai nhất. Ta không can thiệp ở đây. Ta chỉ bí mật chọn một vài chữ để ưu tiên hơn, rồi tăng <code class="language-plaintext highlighter-rouge">weight</code>:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>preferred = {"postponed", "moved"}

for word in preferred:
    weights[word] *= 1.5
</code></pre></div></div>

<table>
  <thead>
    <tr>
      <th>word</th>
      <th style="text-align: right">before</th>
      <th style="text-align: right">×1.5 if preferred</th>
      <th style="text-align: right">normalized</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">"postponed"</code></td>
      <td style="text-align: right">.40</td>
      <td style="text-align: right">.60</td>
      <td style="text-align: right">.48</td>
    </tr>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">"delayed"</code></td>
      <td style="text-align: right">.30</td>
      <td style="text-align: right">.30</td>
      <td style="text-align: right">.24</td>
    </tr>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">"deferred"</code></td>
      <td style="text-align: right">.20</td>
      <td style="text-align: right">.20</td>
      <td style="text-align: right">.16</td>
    </tr>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">"moved"</code></td>
      <td style="text-align: right">.10</td>
      <td style="text-align: right">.15</td>
      <td style="text-align: right">.12</td>
    </tr>
  </tbody>
</table>

<p>Sau pha này, <code class="language-plaintext highlighter-rouge">"postponed"</code> vẫn là lựa chọn tự nhiên nhất; còn <code class="language-plaintext highlighter-rouge">"moved"</code> dù được bias nhưng vẫn đội sổ như ban đầu. Gieo xúc xắc 1 2 lần thì chả có gì bí hiểm; nhưng gieo 1000 lần với cùng phân phối bias, thì luật số lớn cho biết khoảng 600 lần sẽ rơi vào nhóm <code class="language-plaintext highlighter-rouge">preferred</code>. (Lưu ý: 600 rolls cho ra either <code class="language-plaintext highlighter-rouge">"postponed"</code> or <code class="language-plaintext highlighter-rouge">"moved"</code>, không phải riêng <code class="language-plaintext highlighter-rouge">"postponed"</code>.)</p>

<p>Detector lúc này chỉ thực hiện đọc-chép đáp án. Có sẵn danh sách preferred; đọc qua đoạn văn thấy chữ nào nằm trong cái danh sách kia thì count += 1; sau cùng đếm ra preferred xuất hiện tới 60%–67% số lần thì hú.</p>

<p>Cơ chế watermark đơn giản đến mức hơi xúc phạm. Về bản chất, ta không chèn watermark vào bề mặt, mà giấu vào độ lệch thống kê của các lựa chọn; sau đó detector phát hiện cục xúc xắc bị nghiêng đúng như đã thiết kế.</p>

<hr />

<h1 id="giao-tiếp-giữa-embedder-và-detector">Giao tiếp giữa embedder và detector</h1>

<p>Code trên đang ăn gian ở chỗ: <code class="language-plaintext highlighter-rouge">preferred = {"postponed", "moved"}</code>. Ai đã quyết định hai chữ đó là preferred? Detector biết phải đếm hai chữ này vì ta vừa viết thẳng câu trả lời vào code. Thực tế, chỉ có đứa nào dở người mới hard-code một từ điển khổng lồ vào code.</p>

<p>Embedder và detector cần một luật chơi để cùng nhìn một chữ và đi đến cùng kết luận preferred or nah. Ta cần một <code class="language-plaintext highlighter-rouge">secret key</code> theo quy tắc:</p>

<blockquote>
  <p>same key + same word → same yes/no answer</p>
</blockquote>

<p>Chính xác! 2 bartender ở 2 quầy Saobucks, xài cùng công thức pha chế và nguyên liệu giống nhau, sẽ cho ra 2 ly nước giống nhau dù họ chưa gặp nhau bao giờ. Hiển nhiên bạn và tôi không uống công thức. Secret key ở đây cũng vậy. Trong lập trình, để “mix” key và word thành 1 chuỗi thỏa yêu cầu, ta có hàm băm (hash function).</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="n">hashlib</span>

<span class="k">def</span> <span class="nf">is_preferred</span><span class="p">(</span><span class="n">word</span><span class="p">,</span> <span class="n">key</span><span class="p">):</span>
    <span class="n">digest</span> <span class="o">=</span> <span class="n">hashlib</span><span class="p">.</span><span class="nf">sha256</span><span class="p">((</span><span class="n">key</span> <span class="o">+</span> <span class="n">word</span><span class="p">).</span><span class="nf">encode</span><span class="p">()).</span><span class="nf">digest</span><span class="p">()</span>
    <span class="k">return</span> <span class="n">digest</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span> <span class="o">&lt;</span> <span class="mi">128</span>
</code></pre></div></div>

<p>Hàm <code class="language-plaintext highlighter-rouge">sha256()</code> nhận <code class="language-plaintext highlighter-rouge">key</code> + <code class="language-plaintext highlighter-rouge">word</code> rồi trả về một dãy byte tất định: cùng input thì luôn ra cùng output. Ta lấy byte đầu tiên (vốn nằm từ 0 đến 255), rồi chia khoảng đó làm đôi: 0–127 là preferred; 128–255 thì nah. Với key <code class="language-plaintext highlighter-rouge">essay-key-220</code> hiện tại:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nf">is_preferred</span><span class="p">(</span><span class="sh">"</span><span class="s">postponed</span><span class="sh">"</span><span class="p">,</span> <span class="sh">"</span><span class="s">essay-key-220</span><span class="sh">"</span><span class="p">)</span>  <span class="c1"># True
</span><span class="nf">is_preferred</span><span class="p">(</span><span class="sh">"</span><span class="s">delayed</span><span class="sh">"</span><span class="p">,</span>   <span class="sh">"</span><span class="s">essay-key-220</span><span class="sh">"</span><span class="p">)</span>  <span class="c1"># False
</span><span class="nf">is_preferred</span><span class="p">(</span><span class="sh">"</span><span class="s">deferred</span><span class="sh">"</span><span class="p">,</span>  <span class="sh">"</span><span class="s">essay-key-220</span><span class="sh">"</span><span class="p">)</span>  <span class="c1"># False
</span><span class="nf">is_preferred</span><span class="p">(</span><span class="sh">"</span><span class="s">moved</span><span class="sh">"</span><span class="p">,</span>     <span class="sh">"</span><span class="s">essay-key-220</span><span class="sh">"</span><span class="p">)</span>  <span class="c1"># True
</span></code></pre></div></div>

<p>See? Đố tìm thấy gì giấu trong <code class="language-plaintext highlighter-rouge">postponed</code>. Preferred bây giờ không phải một thuộc tính của bản thân chữ <code class="language-plaintext highlighter-rouge">postponed</code> mà là kết quả của cặp <code class="language-plaintext highlighter-rouge">(key, word)</code>. Giữ nguyên word, đổi key:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>is_preferred("postponed", "essay-key-220")  # True
is_preferred("postponed", "another-key")    # False
</code></pre></div></div>

<p>Đổi key, kết quả hash đổi, và cách chia vocabulary cũng đổi theo:</p>

<table>
  <thead>
    <tr>
      <th>word</th>
      <th style="text-align: right"><code class="language-plaintext highlighter-rouge">essay-key-220</code></th>
      <th style="text-align: right"><code class="language-plaintext highlighter-rouge">another-key</code></th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">postponed</code></td>
      <td style="text-align: right">✓</td>
      <td style="text-align: right"> </td>
    </tr>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">delayed</code></td>
      <td style="text-align: right"> </td>
      <td style="text-align: right">✓</td>
    </tr>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">deferred</code></td>
      <td style="text-align: right"> </td>
      <td style="text-align: right"> </td>
    </tr>
    <tr>
      <td><code class="language-plaintext highlighter-rouge">moved</code></td>
      <td style="text-align: right">✓</td>
      <td style="text-align: right">✓</td>
    </tr>
  </tbody>
</table>

<p>Detector từ key có thể tái tạo preferred list riêng mà cơ chế vẫn y nguyên.</p>

<hr />

<h1 id="tôn-hành-giả-giả-hành-tôn">Tôn Hành Giả, Giả Hành Tôn</h1>

<p>Ở Take 2 ta đã watermark đơn giản trên chữ riêng lẻ. Hệ quả là với một key cố định, nếu một chữ được <code class="language-plaintext highlighter-rouge">preferred</code> thì nó mãi mãi là <code class="language-plaintext highlighter-rouge">preferred</code>; sau đó generator đẩy bias về nó. Gọi <em>green</em> kí hiệu $G$ là hàm cho ra chữ được ưu ái (không xài preferred $P$ để tránh nhầm hàm xác suất), khi có secret key $K$ thì ta có một cách đơn giản để quyết định chữ $w$ nào được ưu tiên. Mỗi chữ có một trạng thái cố định:</p>

\[G_K(w)=
\begin{cases}
1 &amp; \text{nếu }w\text{ thuộc green/preferred set}\\
0 &amp; \text{otherwise}
\end{cases}\]

<p>Detector ở đầu dây bên kia chỉ có secret key để tái tạo preferred list, nó không quan tâm generator bias bao nhiêu. Detector nhìn vào văn bản hiện tại và đếm tổng:</p>

\[S=\sum_{i=1}^{N}G_K(w_i)\]

<p>Nếu $S$ cao bất thường, detector bắt đầu nghi ngờ có watermark.</p>

<p>Ở suốt câu chuyện, ta đang quan tâm nhúng watermark thế nào để detector dễ dàng nhận ra. Nhìn kỹ cách làm ta nhận ra có một mối quan tâm khác. Green hay red hay whatsoever là tính chất của bản thân chữ đó chứ không dính dáng gì quyết định. Nếu
$
G_K(\text{“postponed”})=1
$
thì <code class="language-plaintext highlighter-rouge">"postponed"</code> là green ở mọi nơi. Hai câu này đều cho <code class="language-plaintext highlighter-rouge">"postponed"</code> cùng một green bit:</p>

<blockquote>
  <p>We postponed the launch because the database failed overnight.</p>

  <p>The team postponed the migration after several warnings.</p>
</blockquote>

<p>Giả sử có một lĩnh vực quái đản sử dụng “postponed” thường xuyên; hoặc một người có thói quen thích viết chữ đó. Cứ mỗi lần họ viết “postponed”, detector lại được cộng thêm điểm. Khi đủ nhiều thiên hướng sử dụng từ vựng tình cờ khớp với green set, $S$ có thể tăng đơn giản là vì phong cách, chứ không phải vì generator đã cài watermark. Chỉ cần một người viết văn tự nhiên có gu dùng từ lệch vô tình va chạm với bảng màu cố định của secret key, tự thân sự kết hợp đó đã tạo ra một tín hiệu giả.</p>

<p>Nếu detector hú lên, chúc mừng bạn đã quay vào ô <strong><em>false positive</em></strong>. Nói cách khác, dấu hiệu nhận biết đang dính với bản thân các chữ, chứ chưa thực sự phản ánh lựa chọn của watermark.</p>

<p>Giả sử người thật việc thật viết một văn bản hoàn toàn ngẫu nhiên, đều đặn và không nghiện từ nào, tổng này sẽ quanh quẩn ở mức $0.5$ (50% green, 50% red). Detector nghĩ rằng hễ tỉ lệ green $&gt; 0.5$ nghĩa là generator đã cố tình bịp phân phối để chọn green nhiều hơn.</p>

<p>Bây giờ xét văn bản <strong>không watermark</strong> nhưng có có thiên hướng dùng chữ $w$ theo phân phối $p(w)$. Ta kì vọng tỉ lệ chữ đó rơi vào green là:</p>

\[\mathbb E[S] = \sum_w p(w)G_K(w)\]

<p>Nếu green set tình cờ chứa nhiều những chữ mà văn bản này thích dùng, thì:</p>

\[\sum_w p(w)G_K(w) &gt; \frac{1}{2}\]

<p>Ví dụ $ p(\text{“postponed”})=0.30 $ và hàm băm cũng xếp chữ này vào green list: $ G_K(\text{“postponed”}) = 1 $. Chỉ riêng một thiên hướng chọn chữ đã đóng góp $0.3$ vào green rate. Nếu 70% dung lượng còn lại chỉ cần đóng góp thêm $&gt; 0.20$ điểm green nữa (quá dễ xảy ra) cũng tình cờ rơi vào green set, thì tỉ lệ quan sát có thể lệch khá xa khỏi $0.5$.</p>

<p>Chúng ta biết rằng văn bản là một chuỗi các word/token. Thay vì băm chữ riêng lẻ và hỏi chữ này có green không, thì ta thử băm nốt cả chùm dây phía trước nó và hỏi tiếp:</p>

<blockquote>
  <p><strong>Ở context này</strong>, chữ này có green không?</p>
</blockquote>

<p>Để quyết định chữ thứ $i$, ta xét thêm một khoảng context gồm $n$ chữ đứng trước nó:</p>

\[C = (w_{i-n},\ldots,w_{i-1})\]

<p>Hàm quyết định ưu ái green khi có thêm context là</p>

\[G_K(C, w_i)\]

<p>Bây giờ cùng một chữ có thể có trạng thái khác nhau tùy vào context. Tức “postponed” tự nó không còn mang một trạng thái green cố định nữa. Cách nhận diện watermark đã phức tạp lên đáng kể. Tức một chữ thuộc green ở chỗ context này có thể là red ở chỗ khác (tôi gọi red cho nó đủ cặp). Vì vậy detector sẽ chú ý thằng generator cứ chọn đi chọn lại chữ green trong context nào đó:</p>

\[S=\sum_{i=1}^{N}G_K(C,w_i)\]

<p>Giả sử một người thật viết một văn bản $T$ có độ dài $N$, hoàn toàn không được watermark:</p>

\[T=(w_1,\ldots,w_N).\]

<p>Ta xét tính chất pseudorandom của hàm băm. Một thay đổi rất nhỏ ở input, thậm chí chỉ một bit có thể làm output thay đổi mạnh và khó đoán. Giờ xét null hypothesis: văn bản không chứa watermark. Ta giả sử hàm băm sẽ chia vùng green/red cân bằng, tức với một cặp context–word bất kỳ:</p>

\[P\bigl(G_K(C,w)=1\bigr)\approx\frac12.\]

<p>Điểm quan trọng là mỗi lần một chữ xuất hiện, nó đi cùng một context $C$ có thể khác nhau. Vì vậy, hàm băm nhìn vào toàn bộ cặp $(C,w_i)$. Dưới null hypothesis, xác suất để input đó rơi vào green hoặc red xấp xỉ cân bằng:</p>

\[\mathbb E\left[G_K(C,w_i)\mid T\right]
\approx\frac12.\]

<p>Từ đó, với cách detector tính thống kê:</p>

\[S = \sum_{i=1}^{N}G_K(C,w_i)\]

<p>ta có:</p>

\[\mathbb E[S\mid T]
=
\sum_{i=1}^{N}
\mathbb E[G_K(C,w_i)\mid T]
\approx
\sum_{i=1}^{N}\frac12
=
\frac N2\]

<p>Một văn bản có thể thích dùng “postponed” bao nhiêu cũng được. Mỗi lần xuất hiện của “postponed” lại được đánh giá trong context khác, chứ không còn được ánh xạ trực tiếp thành tín hiệu green. Nói đơn giản, context càng giàu, watermark càng ít phụ thuộc vào ý chí chọn chữ của người viết. Băm cùng context, dưới giả định hàm băm ngẫu nhiên, vì thế loại bỏ <strong>một</strong> nguồn false positive do thiên hướng dùng từ vựng.</p>

<hr />

<h1 id="hooman-has-entered-the-chat">Hooman has entered the chat</h1>

<p>Dĩ nhiên tâm lý con người xài AI thì phải sửa xóa vài chỗ. (Lí do tại sao thì tôi và bạn ngầm hiểu với nhau là được). Thử táy máy sửa:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>A B C D E F G
    ↓
A B X D E F G
</code></pre></div></div>

<p>Nhắc lại: lúc nhúng watermark, ta hash chung với context, nên quyết định green tại vị trí $i$ phụ thuộc vào một đoạn lịch sử lựa chọn nằm kề trước nó. Vấn đề là các context này chồng lấn nhau:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>[A B C D] -&gt; E
    [B C D E] -&gt; F
        [C D E F] -&gt; G
</code></pre></div></div>

<p>Một thay đổi nhỏ trong input có thể làm output hash thay đổi mạnh, từ đó cho ra một watermark state hoàn toàn khác. Vì các context chồng lấn nhau, thay đổi ở một token không chỉ ảnh hưởng đến quyết định ngay tại nó, mà còn có thể kéo theo các context phía sau. Giả sử context là $n$ chữ kề trước, thì phụ thuộc của một token có dạng:</p>

\[w_j
\rightarrow
G_j,G_{j+1},\ldots,G_{j+n}\]

<p>với $G_j = G_K(C,w_j)$. Nói cách khác, một chỉnh sử ở $w_j$ <strong>có thể</strong> làm thay đổi tới $n+1$ watermark decisions, dẫn đến một chuỗi thay đổi trong watermark signal.</p>

<p>Ở chiều ngược lại, static hash đơn thuần $G_K(w_i)$, quyết định tại vị trí $i$ chỉ phụ thuộc vào chính $w_i$, nên đối với chỉnh sửa ở $i$ những quyết khác không ảnh hưởng; nhưng phải trả giá bằng việc signal phụ thuộc khá mạnh vào word identity, dễ gây false positive hơn.</p>

<p>Quay lại vấn đề của context. Dù có thêm context giúp giảm false positive song lộ ra điểm yếu ở chỗ mọi thứ trong context đều có quyền ảnh hưởng tới quyết định hiện tại. Vậy nếu ta vẫn muốn giữ context, nhưng chỉ cho <strong>một (hoặc vài) vị trí</strong> làm input cho hàm băm thì sao? Ta gọi các vị trí này là anchor/điểm neo cho quyết định:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>Context:
[A B C D E F G H]

Full contextual:
[A B C D E F G H] -&gt; X
 ^ ^ ^ ^ ^ ^ ^ ^

Anchor-based:
[A B C D E F G H] -&gt; X
       ^       
    anchor
</code></pre></div></div>

<p>Miễn hooman thay đổi chữ ở những vị trí <em>khác anchor</em> thì X hiển nhiên vẫn bảo toàn tính mạng green/red.</p>

<hr />

<h1 id="random-but-not-arbitrary">Random, but not arbitrary</h1>

<p>Ta không muốn anchor là một vị trí <em>cố định</em> trong context. Giả sử context gồm 8 chữ mà ta lấy cố định vị trí 4 luôn thì sao? Chúng ta đã quay lại băm context thuần ở mức cục bộ, chỉ khác là băm một thay vì băm cả 8 =)) Cách này không tận dụng được context như một cái hồ chứa bằng chứng watermark nữa. Btw, chúng ta cũng không nên tặng attacker bia tập bắn.</p>

<p>Anchor linh động cho phép các phần khác nhau của context, nói rộng ra là lịch sử, có cơ hội tham gia vào watermark. Nhưng. Nếu chọn anchor bừa thì detector sau này sẽ hoạt động bằng niềm tin. Vì vậy ta cần một cách để chọn anchor mà cả embedder và detector đều bói ra được. Cụ thể yêu cầu thuật toán chọn vị trí sao cho:</p>
<ul>
  <li>ngẫu nhiên về mặt vị trí;</li>
  <li>và detector vẫn có quy luật để biết.</li>
</ul>

<p>Thật tình cờ hàm băm sẽ băm 8 chữ trong context thành 8 giá trị digest ngẫu nhiên. Nhưng ngẫu nhiên cỡ nào thì chắc chắn trong phạm vi đó ta luôn xác định được một phần tử có digest <strong>nhỏ nhất / lớn nhất</strong>. Voilà!</p>

<p>Giả sử context ta lấy 8 chữ:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>[A, B, C, D, E, F, G, H]
hash(key,A) = 82
hash(key,B) = 14  &lt;- min
hash(key,C) = 95
hash(key,D) = 41
hash(key,E) = 73
hash(key,F) = 56
hash(key,G) = 31
hash(key,H) = 67

anchor position = 2
anchor word     = B
</code></pre></div></div>

<p>Đối với context khác thì thứ tự có thể thay đổi, nên anchor có thể cũng đổi theo. Vậy lúc này quyết định green hay không sẽ là:</p>

\[G_K(c_a, w_i)\]

<p>với $a$ là vị trí anchor trong context $C$ và $c_a$ là chữ đóng vai trò anchor.</p>

<p>Anchor có thực sự làm statistic của detector “sạch” hơn dưới null hypothesis hay không thì không còn hiển nhiên nữa. Lúc này phải nhìn vào variance, correlation, và cuối cùng là empirical test.</p>

<hr />

<h1 id="sinh-văn-bản">Sinh văn bản</h1>

<p>Để thí nghiệm trò nhúng watermark này, chúng ta cần bộ sinh văn bản, bản chất là streaming các lựa chọn nối nhau, thì mới có cái để can thiệp. Nhắc lại <code class="language-plaintext highlighter-rouge">weights</code> ở đầu bài này chứa các options cho một lựa chọn, một cục xúc xắc có các mặt nặng nhẹ khác nhau chờ được bịp. Tôi đã nhét vào những con số rất đẹp, nhưng nó từ đâu ra, nếu như không phải tuân theo Nhatism distribution? Chẳng hạn đang xổ văn bản ở vị trí “far as I…” thì lựa chọn tiếp theo là:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># "far as I..."
</span><span class="n">weights</span> <span class="o">=</span> <span class="p">{</span>
    <span class="sh">"</span><span class="s">can</span><span class="sh">"</span><span class="p">:</span> <span class="mf">0.2857</span><span class="p">,</span> <span class="sh">"</span><span class="s">am</span><span class="sh">"</span><span class="p">:</span> <span class="mf">0.2143</span><span class="p">,</span> <span class="sh">"</span><span class="s">know</span><span class="sh">"</span><span class="p">:</span> <span class="mf">0.1429</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">have</span><span class="sh">"</span><span class="p">:</span> <span class="mf">0.1071</span><span class="p">,</span> <span class="sh">"</span><span class="s">could</span><span class="sh">"</span><span class="p">:</span> <span class="mf">0.1071</span><span class="p">,</span> <span class="sh">"</span><span class="s">was</span><span class="sh">"</span><span class="p">:</span> <span class="mf">0.0714</span><span class="p">,</span>
    <span class="sh">"</span><span class="s">recollect</span><span class="sh">"</span><span class="p">:</span> <span class="mf">0.0357</span><span class="p">,</span> <span class="sh">"</span><span class="s">knew</span><span class="sh">"</span><span class="p">:</span> <span class="mf">0.0357</span><span class="p">}</span>
</code></pre></div></div>

<p>Đó là kết quả của quá trình training (nói trắng ra là đếm) trong một tập văn bản tiếng Anh đủ dài. Model nhìn vào 3 token kề nhau, gọi là context, lấy danh sách các chữ từng xuất hiện kèm tần số của chúng nó. Mỗi khi tập training có chuỗi context là <code class="language-plaintext highlighter-rouge">"far as I"</code> thì <code class="language-plaintext highlighter-rouge">"can"</code> xuất hiện ngay sau đó với số lần nhiều hơn <code class="language-plaintext highlighter-rouge">"am"</code> nên nó có weight nặng hơn.  Ví dụ</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>A B C D E
└───────┘

ta quan tâm bao nhiêu lần:
[A, B, C] → D
[B, C, D] → E
</code></pre></div></div>

<p>Khi đem chia tần số mỗi option cho tổng lần context xuất hiện trên toàn tập train, thì ra được xác suất tương đối, lưu vào <code class="language-plaintext highlighter-rouge">weights</code>. Đến lúc sinh chữ, thì cái context đó lại trượt sang phải, 3 token mới nhất lại được dùng để lookup chữ tiếp theo.</p>

<p>Chính xác! Mô hình n-gram / Markov model: nhìn vào n-1 token gần nhất để tính xác suất cho token tiếp theo. Ví dụ trên tôi đã dùng 4-gram, train trên vài quyển sách, và tôi cam đoan những con số đó là công trình nghiên cứu của tác giả và hoàn toàn trung thực.</p>

<p>Model chả cần hiểu nó đang nói gì, và cũng chả buồn viết đúng ngữ pháp. Nó chỉ cần tạo ra đủ nhiều options ở mỗi bước để chúng ta nghịch. We are NOT building our own LLM.</p>

<hr />

<h1 id="nhúng-watermark">Nhúng watermark</h1>

<p>Ta trước tiên cần hàm quyết định green/red và hàm thống kê cơ bản.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">is_green</span><span class="p">(</span><span class="n">anchor</span><span class="p">,</span> <span class="n">key</span><span class="p">,</span> <span class="n">word</span><span class="p">):</span>
    <span class="n">h</span> <span class="o">=</span> <span class="n">hashlib</span><span class="p">.</span><span class="nf">sha256</span><span class="p">(</span><span class="sa">f</span><span class="sh">"</span><span class="si">{</span><span class="n">anchor</span><span class="si">}</span><span class="s">|</span><span class="si">{</span><span class="n">key</span><span class="si">}</span><span class="s">|</span><span class="si">{</span><span class="n">word</span><span class="si">}</span><span class="sh">"</span><span class="p">.</span><span class="nf">encode</span><span class="p">()).</span><span class="nf">digest</span><span class="p">()</span>
    <span class="k">return</span> <span class="n">h</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span> <span class="o">&lt;</span> <span class="mi">128</span>
    
<span class="k">def</span> <span class="nf">normalize</span><span class="p">(</span><span class="n">weights</span><span class="p">):</span>
    <span class="n">total</span> <span class="o">=</span> <span class="nf">sum</span><span class="p">(</span><span class="n">weights</span><span class="p">.</span><span class="nf">values</span><span class="p">())</span>
    <span class="k">if</span> <span class="n">total</span> <span class="o">&lt;=</span> <span class="mi">0</span><span class="p">:</span>
        <span class="k">return</span> <span class="p">{</span><span class="n">k</span><span class="p">:</span> <span class="mf">1.0</span> <span class="o">/</span> <span class="nf">len</span><span class="p">(</span><span class="n">weights</span><span class="p">)</span> <span class="k">for</span> <span class="n">k</span> <span class="ow">in</span> <span class="n">weights</span><span class="p">}</span>
    <span class="k">return</span> <span class="p">{</span><span class="n">k</span><span class="p">:</span> <span class="n">v</span> <span class="o">/</span> <span class="n">total</span> <span class="k">for</span> <span class="n">k</span><span class="p">,</span> <span class="n">v</span> <span class="ow">in</span> <span class="n">weights</span><span class="p">.</span><span class="nf">items</span><span class="p">()}</span>
    
<span class="k">def</span> <span class="nf">sample_token</span><span class="p">(</span><span class="n">probs</span><span class="p">):</span>
    <span class="n">roll</span> <span class="o">=</span> <span class="n">random</span><span class="p">.</span><span class="nf">random</span><span class="p">()</span>
    <span class="n">cum</span> <span class="o">=</span> <span class="mf">0.0</span>  <span class="c1"># not the cum you think
</span>    <span class="k">for</span> <span class="n">word</span><span class="p">,</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">probs</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
        <span class="n">cum</span> <span class="o">+=</span> <span class="n">p</span>
        <span class="k">if</span> <span class="n">roll</span> <span class="o">&lt;</span> <span class="n">cum</span><span class="p">:</span>
            <span class="k">return</span> <span class="n">word</span>
</code></pre></div></div>

<p>Hàm lấy lựa chọn khả dĩ cho word/token tiếp theo, chính là các mặt của cục xúc xắc, trả về danh sách lựa chọn kèm xác suất của chúng.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># context = tokens[pos-3:pos]  model looks here to predict next word
# history = tokens[pos-8:pos]  watermark looks here to choose anchor
# model = pickle.load(f)       a dict you may ignore
</span><span class="k">def</span> <span class="nf">get_next_token_probs</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">context</span><span class="p">,</span> <span class="n">pre</span><span class="o">=</span><span class="mi">3</span><span class="p">):</span>
    <span class="n">context</span> <span class="o">=</span> <span class="n">context</span><span class="p">[</span><span class="o">-</span><span class="n">pre</span><span class="p">:]</span>
    <span class="n">key</span> <span class="o">=</span> <span class="sh">"</span><span class="s"> </span><span class="sh">"</span><span class="p">.</span><span class="nf">join</span><span class="p">(</span><span class="n">context</span><span class="p">)</span>
    <span class="n">counts</span> <span class="o">=</span> <span class="n">model</span><span class="p">[</span><span class="sh">"</span><span class="s">context_counts</span><span class="sh">"</span><span class="p">][</span><span class="n">key</span><span class="p">]</span>
    <span class="n">total</span> <span class="o">=</span> <span class="nf">sum</span><span class="p">(</span><span class="n">counts</span><span class="p">.</span><span class="nf">values</span><span class="p">())</span>
    <span class="k">return</span> <span class="p">{</span>  <span class="c1"># probs
</span>        <span class="n">word</span><span class="p">:</span> <span class="n">count</span> <span class="o">/</span> <span class="n">total</span>
        <span class="k">for</span> <span class="n">word</span><span class="p">,</span> <span class="n">count</span> <span class="ow">in</span> <span class="n">counts</span><span class="p">.</span><span class="nf">items</span><span class="p">()</span>
    <span class="p">}</span>
</code></pre></div></div>
<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>&gt;&gt;&gt;&gt; get_next_token_probs(model, ['far', 'as', 'I'])
{'can': 0.2857142857142857, 'am': 0.21428571428571427, 'know': 0.14285714285714285, 'have': 0.10714285714285714, 'could': 0.10714285714285714, 'was': 0.07142857142857142, 'recollect': 0.03571428571428571, 'knew': 0.03571428571428571}
</code></pre></div></div>

<p>Tiếp theo là gương mặt thân quen ở đầu bài, nhận cái cục xúc xắc và bơm chì vào những mặt green cho nó nặng hơn:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">watermark</span><span class="p">(</span><span class="n">probs</span><span class="p">,</span> <span class="n">anchor</span><span class="p">,</span> <span class="n">key</span><span class="o">=</span><span class="sh">"</span><span class="s">essay-key-220</span><span class="sh">"</span><span class="p">,</span> <span class="n">boost</span><span class="o">=</span><span class="mf">2.5</span><span class="p">):</span>
    <span class="n">rigged</span> <span class="o">=</span> <span class="p">{}</span>
    <span class="k">for</span> <span class="n">word</span><span class="p">,</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">probs</span><span class="p">.</span><span class="nf">items</span><span class="p">():</span>
        <span class="k">if</span> <span class="nf">is_green</span><span class="p">(</span><span class="n">anchor</span><span class="p">,</span> <span class="n">key</span><span class="p">,</span> <span class="n">word</span><span class="p">):</span>
            <span class="n">p</span> <span class="o">=</span> <span class="n">p</span> <span class="o">*</span> <span class="n">boost</span>
        <span class="n">rigged</span><span class="p">[</span><span class="n">word</span><span class="p">]</span> <span class="o">=</span> <span class="n">p</span>                
    <span class="k">return</span> <span class="nf">normalize</span><span class="p">(</span><span class="n">rigged</span><span class="p">)</span>  <span class="c1"># weights
</span></code></pre></div></div>

<p>Hàm tìm anchor là phần tử có hash nhỏ nhất:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">get_history_window</span><span class="p">(</span><span class="n">tokens</span><span class="p">,</span> <span class="n">pos</span><span class="p">,</span> <span class="n">W</span><span class="o">=</span><span class="mi">8</span><span class="p">):</span>
    <span class="k">return</span> <span class="n">tokens</span><span class="p">[</span><span class="nf">max</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="n">pos</span><span class="o">-</span><span class="n">W</span><span class="p">):</span><span class="n">pos</span><span class="p">]</span>

<span class="k">def</span> <span class="nf">select_anchor</span><span class="p">(</span><span class="n">history</span><span class="p">):</span>  <span class="c1"># min
</span>    <span class="n">anchor</span> <span class="o">=</span> <span class="n">history</span><span class="p">[</span><span class="mi">0</span><span class="p">]</span>
    <span class="n">anchor_hash</span> <span class="o">=</span> <span class="n">hashlib</span><span class="p">.</span><span class="nf">sha256</span><span class="p">(</span><span class="n">anchor</span><span class="p">.</span><span class="nf">encode</span><span class="p">()).</span><span class="nf">digest</span><span class="p">()</span>

    <span class="k">for</span> <span class="n">word</span> <span class="ow">in</span> <span class="n">history</span><span class="p">[</span><span class="mi">1</span><span class="p">:]:</span>  <span class="c1"># sliding
</span>        <span class="n">h</span> <span class="o">=</span> <span class="n">hashlib</span><span class="p">.</span><span class="nf">sha256</span><span class="p">(</span><span class="n">word</span><span class="p">.</span><span class="nf">encode</span><span class="p">()).</span><span class="nf">digest</span><span class="p">()</span>
        <span class="k">if</span> <span class="n">h</span> <span class="o">&lt;</span> <span class="n">anchor_hash</span><span class="p">:</span>
            <span class="n">anchor</span> <span class="o">=</span> <span class="n">word</span>
            <span class="n">anchor_hash</span> <span class="o">=</span> <span class="n">h</span>

    <span class="k">return</span> <span class="n">anchor</span>
</code></pre></div></div>
<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>&gt;&gt;&gt;&gt; history = ["Sherlock", "Holmes", "was", "at",
     "breakfast", "in", "Baker", "Street"]
&gt;&gt;&gt;&gt; for w in history:
&gt;&gt;&gt;&gt;    h = hashlib.sha256(f"{w}".encode()).digest()
&gt;&gt;&gt;&gt;    h = int.from_bytes(h[:4], byteorder="big")
&gt;&gt;&gt;&gt;    print(f"  hash('{w:&lt;10}') = {h}")
hash('Sherlock  ') = 1704073805
hash('Holmes    ') = 263963812
hash('was       ') = 3057359350
hash('at        ') = 2983639323
hash('breakfast ') = 2086201893
hash('in        ') = 1479108435
hash('Baker     ') = 3082403423
hash('Street    ') = 3328596253

&gt;&gt;&gt;&gt; select_anchor(history)
'Holmes'
</code></pre></div></div>

<p>Bây giờ chỉ việc đọc prompt mồi, tìm token hợp lý, bịp, sinh chữ…</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">generate</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">prompt</span><span class="p">,</span> <span class="n">length</span><span class="p">,</span> <span class="n">key</span><span class="p">,</span> <span class="n">boost</span><span class="o">=</span><span class="mf">2.5</span><span class="p">,</span> <span class="n">pre</span><span class="o">=</span><span class="mi">3</span><span class="p">,</span> <span class="n">W</span><span class="o">=</span><span class="mi">8</span><span class="p">):</span>
    <span class="n">tokens</span> <span class="o">=</span> <span class="n">prompt</span><span class="p">.</span><span class="nf">split</span><span class="p">()</span>

    <span class="k">for</span> <span class="n">_</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">length</span><span class="p">):</span>
        <span class="n">context</span> <span class="o">=</span> <span class="n">tokens</span><span class="p">[</span><span class="o">-</span><span class="n">pre</span><span class="p">:]</span>        <span class="c1"># 4-gram so pre = 3
</span>        <span class="n">history</span> <span class="o">=</span> <span class="n">tokens</span><span class="p">[</span><span class="o">-</span><span class="n">W</span><span class="p">:]</span>          <span class="c1"># watermark history
</span>
        <span class="n">probs</span>  <span class="o">=</span> <span class="nf">get_next_token_probs</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">context</span><span class="p">)</span>
        <span class="n">anchor</span> <span class="o">=</span> <span class="nf">select_anchor</span><span class="p">(</span><span class="n">history</span><span class="p">)</span>
        <span class="n">probs</span>  <span class="o">=</span> <span class="nf">watermark</span><span class="p">(</span><span class="n">probs</span><span class="p">,</span> <span class="n">anchor</span><span class="p">,</span> <span class="n">key</span><span class="p">,</span> <span class="n">boost</span><span class="p">)</span>  <span class="c1"># rig it
</span>
        <span class="n">word</span> <span class="o">=</span> <span class="nf">sample_token</span><span class="p">(</span><span class="n">probs</span><span class="p">)</span>
        <span class="n">tokens</span><span class="p">.</span><span class="nf">append</span><span class="p">(</span><span class="n">word</span><span class="p">)</span>

    <span class="k">return</span> <span class="n">tokens</span>
</code></pre></div></div>
<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>&gt;&gt;&gt;&gt; " ".join(generate(model, "far as I", 30, "essay-key-220"))
'far as I could see in the clouds . Manderson , ” said he . ' " The solicitors had , in fact , faintly sulky . ” A step was heard on'
</code></pre></div></div>

<h1 id="người-phán-xử">Người phán xử</h1>

<p>Ôn nhanh một chút về kiểm định giả thuyết (hypothesis testing). Ta bắt đầu với một giả thuyết gốc $H_0$, ở đây là “văn bản tự nhiên con người viết”. Từ $H_0$, ta biết hoặc ước lượng được phân phối của một statistic nếu dữ liệu thực sự chỉ là ngẫu nhiên. Sau đó ta xem statistic quan sát được lệch khỏi kỳ vọng của $H_0$ bao nhiêu. Nếu độ lệch đủ lớn, ta có bằng chứng để bác bỏ $H_0$ tức là văn bản có watermark.</p>

<p>Ở đây statistic của ta là số token green, $G$. Dưới $H_0$, tức là văn bản không được watermark, model cho ta kỳ vọng $\mu$ và variance $V$ của số green. Ta chuẩn hoá độ lệch bằng z-score:</p>

\[z = \frac{G-\mu}{\sqrt{V}}.\]

<p>Nói nôm na, $z$ trả lời một câu <em>số green mà tôi vừa thấy cách kỳ vọng tự nhiên bao nhiêu (độ lệch chuẩn)?</em> Một $z$ nhỏ có thể dễ dàng xảy ra do ngẫu nhiên; một $z$ lớn thì ngày càng khó giải thích nếu $H_0$ là đúng. Vì vậy detector không chỉ hỏi <em>“có nhiều green không?”</em>, mà hỏi <em>“có nhiều green hơn mức model tự nhiên kỳ vọng, đến mức đáng ngờ không?”</em></p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">green_indicator</span><span class="p">(</span><span class="n">anchor</span><span class="p">,</span> <span class="n">key</span><span class="p">,</span> <span class="n">word</span><span class="p">):</span>
    <span class="k">return</span> <span class="nf">int</span><span class="p">(</span><span class="nf">is_green</span><span class="p">(</span><span class="n">anchor</span><span class="p">,</span> <span class="n">key</span><span class="p">,</span> <span class="n">word</span><span class="p">))</span>

<span class="k">def</span> <span class="nf">green_probability</span><span class="p">(</span><span class="n">probs</span><span class="p">,</span> <span class="n">anchor</span><span class="p">,</span> <span class="n">key</span><span class="p">):</span>
    <span class="k">return</span> <span class="nf">sum</span><span class="p">(</span>
        <span class="n">p</span> <span class="k">for</span> <span class="n">word</span><span class="p">,</span> <span class="n">p</span> <span class="ow">in</span> <span class="n">probs</span><span class="p">.</span><span class="nf">items</span><span class="p">()</span>
        <span class="k">if</span> <span class="nf">is_green</span><span class="p">(</span><span class="n">anchor</span><span class="p">,</span> <span class="n">key</span><span class="p">,</span> <span class="n">word</span><span class="p">)</span>
    <span class="p">)</span>

<span class="k">def</span> <span class="nf">detect</span><span class="p">(</span><span class="n">tokens</span><span class="p">,</span> <span class="n">model</span><span class="p">,</span> <span class="n">key</span><span class="p">,</span> <span class="n">W</span><span class="o">=</span><span class="mi">8</span><span class="p">,</span> <span class="n">pre</span><span class="o">=</span><span class="mi">3</span><span class="p">):</span>
    <span class="n">G</span> <span class="o">=</span> <span class="n">mu</span> <span class="o">=</span> <span class="n">V</span> <span class="o">=</span> <span class="mf">0.0</span>

    <span class="k">for</span> <span class="n">t</span> <span class="ow">in</span> <span class="nf">range</span><span class="p">(</span><span class="n">pre</span><span class="p">,</span> <span class="nf">len</span><span class="p">(</span><span class="n">tokens</span><span class="p">)):</span>
        <span class="n">context</span> <span class="o">=</span> <span class="n">tokens</span><span class="p">[</span><span class="n">t</span><span class="o">-</span><span class="n">pre</span><span class="p">:</span><span class="n">t</span><span class="p">]</span>
        <span class="n">history</span> <span class="o">=</span> <span class="n">tokens</span><span class="p">[</span><span class="n">t</span><span class="o">-</span><span class="n">W</span><span class="p">:</span><span class="n">t</span><span class="p">]</span>

        <span class="n">probs</span> <span class="o">=</span> <span class="nf">get_next_token_probs</span><span class="p">(</span><span class="n">model</span><span class="p">,</span> <span class="n">context</span><span class="p">)</span>
        <span class="n">anchor</span> <span class="o">=</span> <span class="nf">select_anchor</span><span class="p">(</span><span class="n">history</span><span class="p">)</span>

        <span class="n">G</span> <span class="o">+=</span> <span class="nf">green_indicator</span><span class="p">(</span><span class="n">anchor</span><span class="p">,</span> <span class="n">key</span><span class="p">,</span> <span class="n">tokens</span><span class="p">[</span><span class="n">t</span><span class="p">])</span>

        <span class="n">q</span> <span class="o">=</span> <span class="nf">green_probability</span><span class="p">(</span><span class="n">probs</span><span class="p">,</span> <span class="n">anchor</span><span class="p">,</span> <span class="n">key</span><span class="p">)</span>
        <span class="n">mu</span> <span class="o">+=</span> <span class="n">q</span>
        <span class="n">V</span> <span class="o">+=</span> <span class="n">q</span> <span class="o">*</span> <span class="p">(</span><span class="mi">1</span> <span class="o">-</span> <span class="n">q</span><span class="p">)</span>

    <span class="n">z</span> <span class="o">=</span> <span class="p">(</span><span class="n">G</span> <span class="o">-</span> <span class="n">mu</span><span class="p">)</span> <span class="o">/</span> <span class="n">math</span><span class="p">.</span><span class="nf">sqrt</span><span class="p">(</span><span class="n">V</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">z</span>
</code></pre></div></div>

<p>Với vị trí $i$, ta có $C =(w_{i-n},\ldots,w_{i-1})$. Khi đó:</p>

\[q_i
=
\sum_w P_M(w\mid C)\,G_K(C,w)\]

<p>Tức giữ nguyên context $C$, nhìn vào toàn bộ phân phối từ mà model có thể sinh ra, rồi cộng xác suất của những token được hash thành green. Ví dụ nếu ở context hiện tại model cho:</p>

\[\begin{array}{c|c|c}
w &amp; P_M(w\mid C) &amp; G_K(C,w)\\
\hline
\text{said} &amp; 0.40 &amp; 1\\
\text{asked} &amp; 0.30 &amp; 0\\
\text{replied} &amp; 0.20 &amp; 1\\
\text{looked} &amp; 0.10 &amp; 0
\end{array}\]

<p>thì:</p>

\[q_i=0.40+0.20=0.60.\]

<p>Tức là <strong>ngay cả khi không watermark</strong>, với context này model vốn đã có $60\%$ xác suất chọn một token green. Đây chính là lý do ta không thể chỉ nhìn $S$ rồi phán “nhiều green = watermark”. Từ đó nối thẳng sang detector, thì số green quan sát được là:</p>

\[S=\sum_{i=1}^{N}G_K(C,w_i)\]

<p>Còn số green model tự nhiên kỳ vọng là:</p>

\[\mu=\sum_{i=1}^{N}q_i\]

<p>Mỗi token thứ $i$ được xem như một phép thử Bernoulli độc lập có xác suất thành công (màu green) là $q_i$. Phương sai của một biến Bernoulli là $q_i(1-q_i)$.Vì các bước được giả định là độc lập (detector nhận văn bản chết cố định), tổng phương sai $V$ đơn giản là tổng các phương sai thành phần:</p>

\[V=\sum_{i=1}^{N}q_i(1-q_i).\]

<p>Cuối cùng:</p>

\[z=\frac{S-\mu}{\sqrt V}.\]

<p>Detector thấy $S$ green. Nhưng với chính những context này, model vốn đã kỳ vọng $\mu$ green. Vậy phần green dư ra có lớn đến mức bất thường không.</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>Detector Output for 30 streamed words:
  tokens_evaluated    : 30
  green_count         : 24
  green_rate          : 0.8
  expected_green      : 20.85
  variance            : 3.15
  std_dev             : 1.77
  excess              : 3.15
  z_score             : 1.777
  detected            : False
</code></pre></div></div>

<p>Oops. Chẳng phải ta đã watermark rồi hay sao. Nhưng detector bảo là False? 24/30 green không hề đồng nghĩa với “đã phát hiện watermark”. Với sample chỉ có 30 token, một vài lựa chọn green thêm vào đã có thể đẩy tỷ lệ từ 50% lên 80%. Detector phải tự kiềm chế và nói có tín hiệu hơi đáng ngờ, nhưng chưa đủ dữ liệu để kết luận. Cái False vì thế là ví dụ rất phản trực giác but but 80% green. Muốn có bằng chứng thống kê, ta cần tín hiệu đủ lớn và sample đủ dài.</p>

<hr />

<h1 id="xóa-dấu-vết">Xóa dấu vết</h1>

<p>Cả bài ta đã đi qua 3 cách quyết định một chữ/token có được ưu ái hay không: Static Word Hash (Take 2), Full Contextual Hash, và Anchor. Cả ba đều tạo ra cùng một loại tín hiệu là tăng xác suất chọn một nhóm token, nhưng khác nhau ở một điểm quan trọng: <em>bao nhiêu phần của history có quyền ảnh hưởng đến quyết định hiện tại</em>.</p>

<p>Vì vậy, thay vì chỉ hỏi <em>watermark có detect được không?</em> ta muốn xem chuyện gì xảy ra khi văn bản bị sửa. Một watermark tốt là watermark sống sót sau những lần hooman cố tình sửa.</p>

<p>Ta dùng cùng một language model và cùng prompt để tạo các văn bản mẫu. Sau đó tiến hành chỉnh sửa và đo tín hiệu watermark còn sót lại. Robustness:</p>

\[\displaystyle R_z=\frac{z_{\rm attacked}}{z_{\rm clean}}\]

<table>
  <thead>
    <tr>
      <th>Parameter</th>
      <th>Value</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Generation</td>
      <td>1,000 tokens, 5 seeds</td>
    </tr>
    <tr>
      <td>Boost $\gamma$</td>
      <td><strong>2.5</strong></td>
    </tr>
    <tr>
      <td>Contextual / Anchor</td>
      <td>$C=3$, $W=8$</td>
    </tr>
    <tr>
      <td>Attacks</td>
      <td>replacement / insertion / deletion / mixed</td>
    </tr>
    <tr>
      <td>Edit rate</td>
      <td>5% 20%</td>
    </tr>
    <tr>
      <td>Detection</td>
      <td><strong>$z \ge 4$</strong></td>
    </tr>
  </tbody>
</table>

<blockquote>
  <p><strong>Baseline:</strong> Với cùng cấu hình trên, cả ba scheme đều đạt 100% detection trên 5 clean generations: Static $z=6.93$, Contextual $z=8.10$, Anchor $z=6.78$.</p>
</blockquote>

<table>
  <thead>
    <tr>
      <th>Attack</th>
      <th style="text-align: right">Rate</th>
      <th style="text-align: right">Static</th>
      <th style="text-align: right">Contextual</th>
      <th style="text-align: right">Anchor</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Replacement</td>
      <td style="text-align: right">5%</td>
      <td style="text-align: right">89.2%</td>
      <td style="text-align: right">75.0%</td>
      <td style="text-align: right">94.5%</td>
    </tr>
    <tr>
      <td>Insertion</td>
      <td style="text-align: right">5%</td>
      <td style="text-align: right">96.2%</td>
      <td style="text-align: right">81.4%</td>
      <td style="text-align: right">91.6%</td>
    </tr>
    <tr>
      <td>Deletion</td>
      <td style="text-align: right">5%</td>
      <td style="text-align: right">100.3%</td>
      <td style="text-align: right">83.8%</td>
      <td style="text-align: right">94.2%</td>
    </tr>
    <tr>
      <td>Mixed</td>
      <td style="text-align: right">5%</td>
      <td style="text-align: right">94.5%</td>
      <td style="text-align: right">74.7%</td>
      <td style="text-align: right">87.3%</td>
    </tr>
    <tr>
      <td>.</td>
      <td style="text-align: right">-</td>
      <td style="text-align: right">-</td>
      <td style="text-align: right">-</td>
      <td style="text-align: right">-</td>
    </tr>
    <tr>
      <td>Replacement</td>
      <td style="text-align: right">20%</td>
      <td style="text-align: right">47.2%</td>
      <td style="text-align: right">47.9%</td>
      <td style="text-align: right">43.4%</td>
    </tr>
    <tr>
      <td>Insertion</td>
      <td style="text-align: right">20%</td>
      <td style="text-align: right">78.6%</td>
      <td style="text-align: right">35.3%</td>
      <td style="text-align: right">63.4%</td>
    </tr>
    <tr>
      <td>Deletion</td>
      <td style="text-align: right">20%</td>
      <td style="text-align: right">91.1%</td>
      <td style="text-align: right">40.6%</td>
      <td style="text-align: right">48.2%</td>
    </tr>
    <tr>
      <td>Mixed</td>
      <td style="text-align: right">20%</td>
      <td style="text-align: right">68.8%</td>
      <td style="text-align: right">40.4%</td>
      <td style="text-align: right">70.6%</td>
    </tr>
  </tbody>
</table>

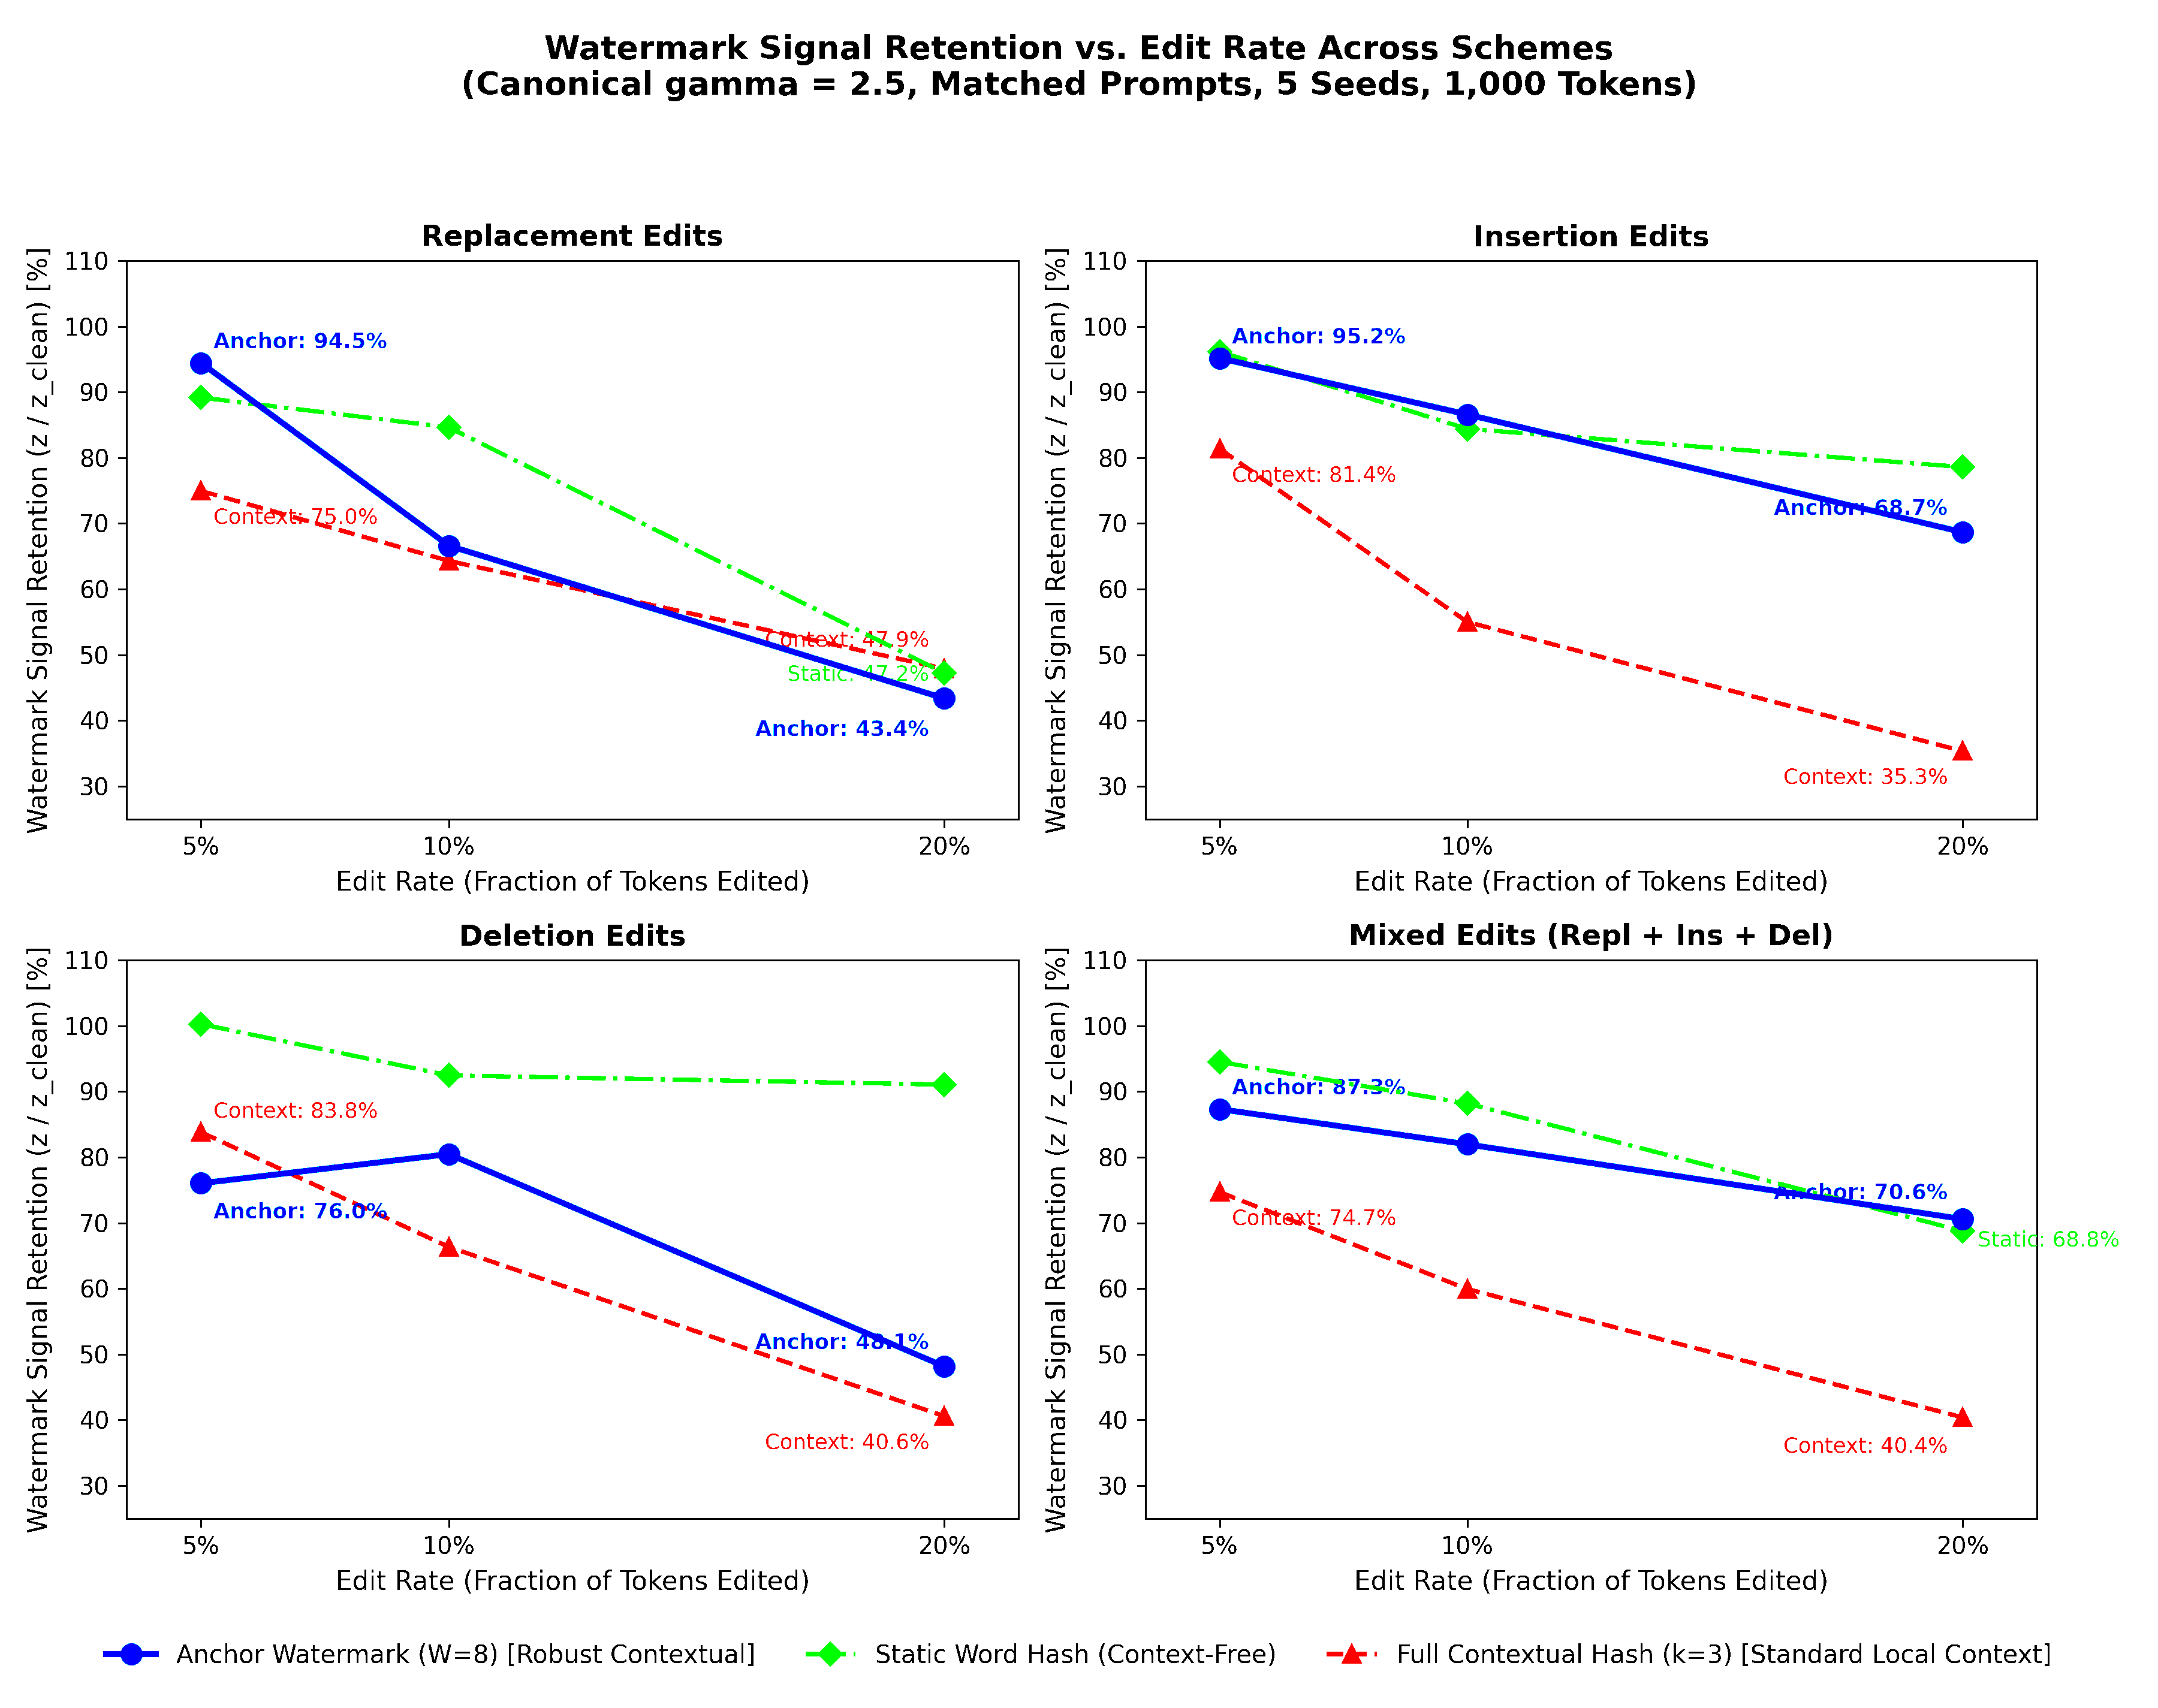
<p>Ở 5% edit, Anchor giữ được khoảng 87–95% signal, trong khi Full Contextual chỉ khoảng 75–84%. Khi edit nặng 20%, cả ba đều suy giảm; Anchor không miễn nhiễm, nhưng đặc biệt giữ lợi thế rõ rệt trước insertion và mixed edits.</p>

<p><img src="/essays/images/2026/watermark-robustness-signal.png" alt="Watermark Robustness Plot" /></p>

<p>Tập trung vào riêng Anchor toi còn tò mò edit làm hỏng history (8 token phía trước) đến mức nào, và trong số đó anchor thực sự đổi bao nhiêu. Ở mức 5% edit, history của một token bị thay đổi ở khoảng 34% vị trí, nhưng anchor chỉ thay đổi khoảng 6–8%. Nói cách khác, phần lớn những thay đổi của history không đủ mạnh để thay đổi “token đại diện” mà watermark đang bám vào. Anchor làm cho watermark ít quan tâm đến những thay đổi nhỏ của history.</p>

<table>
  <thead>
    <tr>
      <th>Attack</th>
      <th style="text-align: right">Rate</th>
      <th style="text-align: right">History changed</th>
      <th style="text-align: right">Anchor changed</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Replacement</td>
      <td style="text-align: right">5%</td>
      <td style="text-align: right">34.4%</td>
      <td style="text-align: right">8.3%</td>
    </tr>
    <tr>
      <td>Insertion</td>
      <td style="text-align: right">5%</td>
      <td style="text-align: right">33.6%</td>
      <td style="text-align: right">5.6%</td>
    </tr>
    <tr>
      <td>Deletion</td>
      <td style="text-align: right">5%</td>
      <td style="text-align: right">34.6%</td>
      <td style="text-align: right">7.9%</td>
    </tr>
    <tr>
      <td>Mixed</td>
      <td style="text-align: right">5%</td>
      <td style="text-align: right">34.5%</td>
      <td style="text-align: right">7.2%</td>
    </tr>
    <tr>
      <td>Replacement</td>
      <td style="text-align: right">20%</td>
      <td style="text-align: right">83.3%</td>
      <td style="text-align: right">29.4%</td>
    </tr>
    <tr>
      <td>Insertion</td>
      <td style="text-align: right">20%</td>
      <td style="text-align: right">79.5%</td>
      <td style="text-align: right">21.3%</td>
    </tr>
    <tr>
      <td>Deletion</td>
      <td style="text-align: right">20%</td>
      <td style="text-align: right">83.4%</td>
      <td style="text-align: right">28.2%</td>
    </tr>
    <tr>
      <td>Mixed</td>
      <td style="text-align: right">20%</td>
      <td style="text-align: right">81.1%</td>
      <td style="text-align: right">24.8%</td>
    </tr>
  </tbody>
</table>

<h3 id="bonus-lexical-preference">Bonus: lexical preference</h3>

<p>Ở bảng đầu tiên Static Word Hash chiếm ưu điểm khá lớn, nhưng nên nhớ ta vẫn còn false positive. Một câu hỏi ngược lại: liệu một văn bản <strong>không hề biết key</strong> nhưng có một thiên hướng từ vựng nào đó vô tình trông giống watermark hay không?</p>

<p><strong>Setup:</strong> 100 văn bản × 500 keys, Static Word Hash. False positive nghĩa là có một văn bản vượt ngưỡng ($z \ge 4$) cho ít nhất 1 key.</p>

<table>
  <thead>
    <tr>
      <th>Preference</th>
      <th style="text-align: right">$z \ge 4$ crossings</th>
      <th style="text-align: right">Text-level FP</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Normal</td>
      <td style="text-align: right">1 / 50,000</td>
      <td style="text-align: right">1 / 100 (1%)</td>
    </tr>
    <tr>
      <td>Speech ×2</td>
      <td style="text-align: right">1 / 50,000</td>
      <td style="text-align: right">1 / 100 (1%)</td>
    </tr>
    <tr>
      <td>Perception ×2</td>
      <td style="text-align: right">2 / 50,000</td>
      <td style="text-align: right">2 / 100 (2%)</td>
    </tr>
    <tr>
      <td>Motion ×2</td>
      <td style="text-align: right">4 / 50,000</td>
      <td style="text-align: right">2 / 100 (2%)</td>
    </tr>
    <tr>
      <td>Mixed ×2</td>
      <td style="text-align: right">1 / 50,000</td>
      <td style="text-align: right">1 / 100 (1%)</td>
    </tr>
    <tr>
      <td>Motion ×3</td>
      <td style="text-align: right">1 / 50,000</td>
      <td style="text-align: right">1 / 100 (1%)</td>
    </tr>
  </tbody>
</table>

<p>Với văn bản bình thường, detector vẫn khá ổn áp, không có sample nào vượt $z=4$. Seems right. Nhưng tôi chơi <strong>key-blind lexical-preference test</strong>: trong lúc generate, tôi cố tình tăng xác suất của một nhóm verb (hành văn của tôi là verb-centric btw) như speech verbs, perception verbs, motion verbs, hoặc các nhóm mixed mà không hề nhìn vào watermark key hay green/red labels. Kết quả mới này lộ ra failure mode: một số lexical preference tình trùng với green vocabulary và đẩy $z$ vượt 4.</p>

<p>Tôi đã xài thêm <code class="language-plaintext highlighter-rouge">fox stoplist</code> để chặn những signal từ stopwords (các từ hầu hết chả mang tí thông tin gì) và các chữ mang tính grammar / structural… Người hay máy thì cũng xài mấy chữ này thôi, nên chả có nhiều giá trị để mà phân biệt.</p>

<p>Để ý preference <code class="language-plaintext highlighter-rouge">motion</code> từ ×2 lên ×3 không chỉ đơn giản là “thêm signal”. Preference mạnh hơn làm phân phối token thay đổi nhiều hơn dẫn đế trajectory của cả văn bản cũng đổi, nên dù có ×3 có thể vô tình đi vào những vùng ít thuận lợi cho một static green partition nào đó. Vì vậy con số FP ở bảng trên không nhất thiết tăng đơn điệu.</p>

<hr />

<h1 id="đồ-chơi">Đồ chơi</h1>

<p>Đồ chơi có sẵn ở Github: <a href="https://github.com/nhatism/toys/tree/main/watermark"><code class="language-plaintext highlighter-rouge">nhatism/toys</code></a>. Cơ bản là chạy train ngrams -&gt; lưu pkl -&gt; vào notebook nghịch. Mọi người muốn chạy thí nghiệm phá phách gì đó thì prompt AI. Chuyện muỗi ấy mà.</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>watermark/
      ├── corpus/ (txt files + license)
      ├── notebooks/
      │    └── anchor-watermark.ipynb
      └── src/
           └── train.py
</code></pre></div></div>

<hr />

<h1 id="mọt-sách">Mọt sách</h1>

<ul>
  <li><strong>Green-list / red-list:</strong> Kirchenbauer et al. (2023) — cách tiếp cận kinh điển: hash context để chia vocabulary thành Green/Red rồi bias sampling về Green tokens.</li>
  <li><strong>Distortion-free watermarking:</strong> Kuditipudi et al. và SynthID-Text — thay vì bias token distribution, watermark nằm trong cách sampler sử dụng keyed randomness, hướng tới giữ nguyên chất lượng sinh.</li>
  <li><strong>Semantic watermarking:</strong> SemStamp và SIR — chuyển signal từ token identity sang semantic representation, với mục tiêu sống sót tốt hơn qua paraphrase.</li>
  <li><strong>Post-hoc watermarking:</strong> PostMark — không cần can thiệp trực tiếp vào sampler; signal được thêm sau generation dựa trên semantic content.</li>
  <li><strong>Robustness:</strong> Đây là trade-off xuyên suốt các hướng trên: token-level schemes khá đơn giản nhưng dễ mất signal khi rewrite mạnh, trong khi semantic schemes robust hơn nhưng thường đắt và phức tạp hơn.</li>
  <li><strong>Survey:</strong> Liu et al., <em>A Survey of Text Watermarking in the Era of Large Language Models</em> — nếu muốn nhìn toàn bộ landscape trong một chỗ.</li>
</ul>]]></content><author><name>nhatism</name></author><summary type="html"><![CDATA[The first lot fell to Jehoiarib, the second to Jedaiah, the third to Harim, […] and the twenty-fourth to Maaziah. — 1 Chronicles 24:7–19]]></summary></entry><entry><title type="html">Perceptron Learning Algorithm</title><link href="https://nhat.codeberg.page/essays/perceptron.html" rel="alternate" type="text/html" title="Perceptron Learning Algorithm" /><published>2019-12-09T00:00:00+07:00</published><updated>2019-12-09T00:00:00+07:00</updated><id>https://nhat.codeberg.page/essays/perceptron.html</id><content type="html" xml:base="https://nhat.codeberg.page/essays/perceptron.html"><![CDATA[<blockquote>
  <p>Bài viết từ 2019 nên có thể lỗi thời hoặc tác giả chưa đủ chín chắn tại thời điểm đó. Read at your own risk.</p>
</blockquote>

<h1 id="giới-thiệu">Giới thiệu</h1>

<h3 id="bài-toán-phân-loại-classification">Bài toán phân loại (classification)</h3>
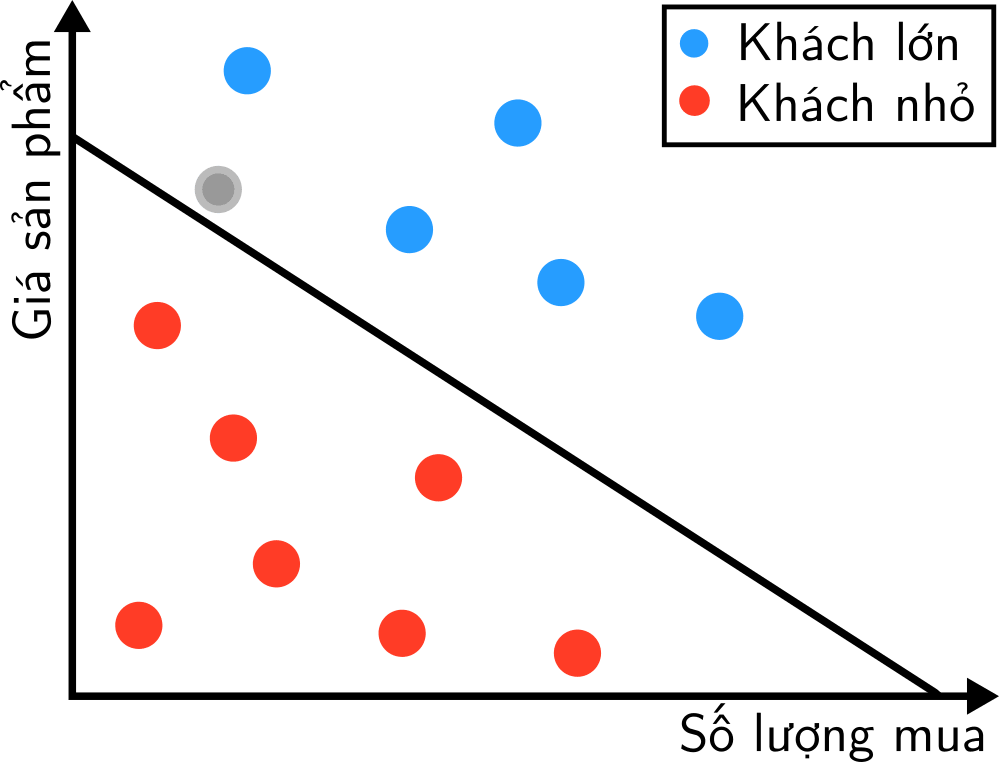
<p>Giả sử chúng ta cần chia khách hàng ra làm hai loại/lớp (category/class) dựa vào nguồn lợi họ đem lại cho công ty: khách hàng nhỏ và khách hàng lớn. Về cơ bản, nguồn lợi được tính theo giá mặt hàng và số lượng khách mua. Như vậy, ta sẽ biểu diễn khách hàng theo hai yếu tố trên trên mặt phẳng:</p>

<p><img src="/essays/images/2019/classification.png" alt="" width="50%" /></p>

<p>Bài toán của chúng ta là từ những điểm xanh và đỏ cho trước (tức marketer đã xác định), hãy xây dựng một quy tắc phân loại để dự đoán class của điểm màu xám. Nói cách khác, chúng ta cần xác định một <em>biên giới</em> để chia lãnh thổ của hai class này, rồi với điểm cần phân loại màu xám ta chỉ cần xem nó nằm ở phía bên nào của đường biên giới là xong. Biên giới đơn giản nhất (theo đúng nghĩa toán học) trong mặt phẳng là một đường thằng (đường màu đen trong hình), trong không gian ba chiều là một mặt phẳng, trong không gian nhiều chiều là một siêu phẳng (hyperplane, một không gian có số chiều nhỏ hơn không gian chứa nó một chiều).</p>

<p>Lưu ý rằng các khái niệm <em>lớp</em>, <em>nhãn</em>, <em>danh mục</em> ở bài toán phân loại là tương tự nhau.</p>

<h3 id="perceptron">Perceptron</h3>

<p>Perceptron Learning Algorithm, gọi ngắn là Perceptron, là một thuật toán giúp chúng ta thực hiện công việc phân loại với hai lớp như trên, ta sẽ gọi hai lớp này là {+1, -1}. Thuật toán ban đầu được <a href="https://en.wikipedia.org/wiki/Frank_Rosenblatt">Frank Rosenblatt</a> đề xuất dựa trên ý tưởng mô phỏng neuron sinh học, nó nhanh chóng tạo nên tiếng vang lớn trong lĩnh vực AI. Không giống như Naive Bayes - một thuật toán phân loại bằng cách tính xác xuất trên toàn bộ tập dữ liệu (batch learning), Perceptron sẽ đọc từng dữ liệu và điều chỉnh <em>biên giới</em> sao cho tất cả các điểm nằm cùng một phía của <em>biên giới</em> có nhãn giống nhau (online learning).</p>

<h3 id="linear-separability">Linear Separability</h3>

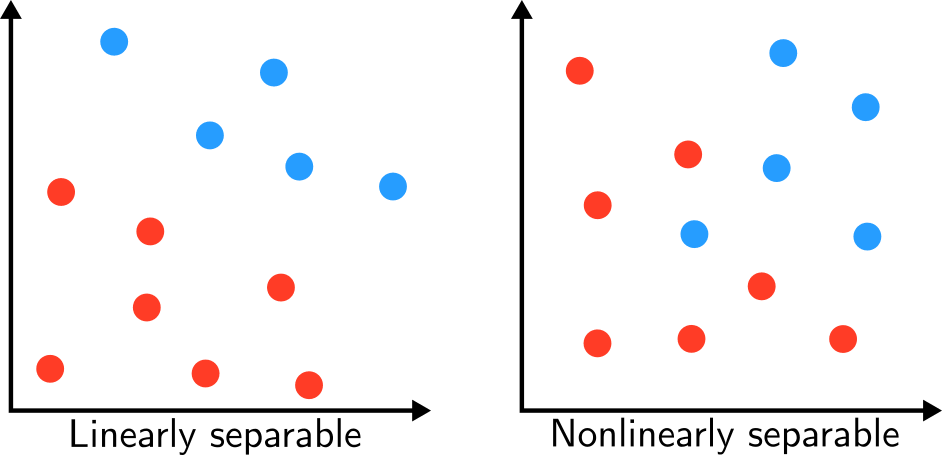
<p>Một nhược điểm của Perceptron là nó chỉ hoạt động thực sự tốt khi dữ liệu phân tách tuyến tính (linearly separable), tức có thể dùng đường thẳng, mặt phẳng, siêu phẳng để làm <em>biên giới</em>, nếu dữ liệu không thỏa điều kiện này, không những Perceptron mà bất kì thuật toán phân loại tuyến tính nào cũng sẽ fail “nhè nhẹ”. Điều này dẫn đến một khái niệm quan trọng là <em>Linear Seperability</em>.</p>

<p>Cho vector $ \bold{x}_i $ biểu diễn một dữ liệu, $y_i$ là nhãn của $\bold{x}_i$ và $f(\bold{x}_i, y_i) = y_i \bold{x}_i$ là feature function của dữ liệu, tập dữ liệu này được gọi là <em>linearly separable</em> nếu tồn tại một vector trọng số $\bold{w}$ và một margin $p &gt; 0$ sao cho:</p>

<p>\(\forall (\bold{x}_i, y_i) \in Dataset, \ \ \bold{w} \cdot f(\bold{x}_i, y_i) \geq p + \bold{w} \cdot f(\bold{x}_i, y')\)
với $y’$ khác $y_i$, là nhãn của lớp còn lại. Điều này khá dễ hiểu vì khi $\bold{x}_i \cdot \bold{w}^\top$ cùng dấu với $y_i$, tức phân lớp đúng, thì tích của chúng không âm.</p>

<p><img src="/essays/images/2019/linear-seperability.png" alt="" width="80%" /></p>

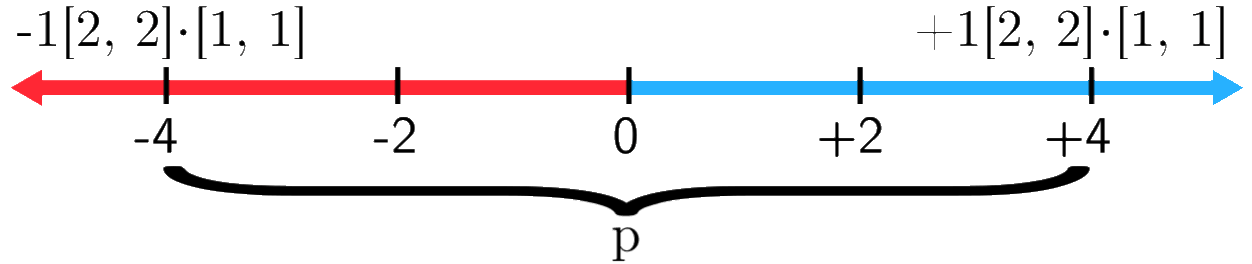
<p>Ví dụ ta có vector trọng số $\bold{w} = [1, 1]$ và vector $\bold{x} = [2, 2]$ có nhãn $y = 1$, như vậy thay vào công thức trên ta được:</p>

<p>\(1 [2, 2] \cdot [1, 1] \geq p + (-1)[2, 2] \cdot [1, 1]\)
\(\Leftrightarrow 4 \geq p + (-4) \Leftrightarrow p \leq 8\)</p>

<p><img src="/essays/images/2019/another-linear-seperability.png" alt="" width="80%" /></p>

<p>Nói cách khác, dữ liệu là linearly separable khi hai tập bao lồi các điểm của hai lớp không giao nhau.</p>

<p>Dữ liệu trên thực tế thường hiếm khi linearly separable là một hạn chế cho Perceptron, tuy nhiên Perceptron vẫn là nền tảng cho các thuật toán Neural Network hay Deep Learning sau này.</p>

<h1 id="thuật-toán-perceptron">Thuật toán Perceptron</h1>

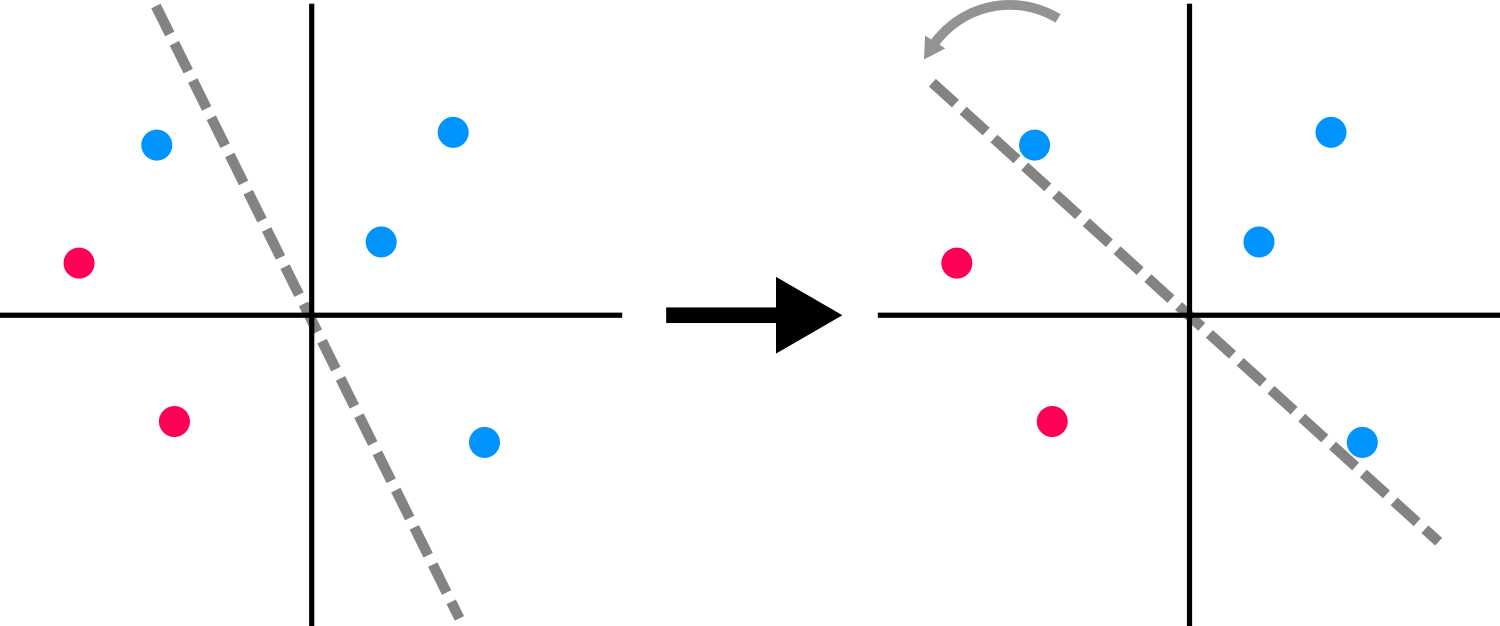
<p>Chúng ta có đường nét đứt là biên giới phân lớp. Thuật toán sẽ dùng đường biên giới để thử phân loại dữ liệu, với mỗi lần phân loại thử bị sai, thuật toán sẽ điều chỉnh lại biên giới. Ở hình bên trái, có một điểm xanh nằm cùng <em>lãnh thổ</em> với các điểm màu đỏ, do đó nó bị thuật toán phân loại sai. Thuật toán sẽ điều chỉnh biên giới sao cho điểm này dần được đưa về <em>lãnh thổ</em> của các điểm xanh.</p>

<p><img src="/essays/images/2019/perceptron-idea.png" alt="" /></p>

<p>Trước đó ta đã đề cập:
\(y_i \bold{x}_i \cdot \bold{w}^\top \geq p + y' \bold{x}_i \cdot \bold{w}^\top\)</p>

<p>Vì $p &gt; 0$ nên
\(y_i \bold{x}_i \cdot \bold{w}^\top &gt; y' \bold{x}_i \cdot \bold{w}^\top \ \ \ \ \ (1)\)
Vì $y’ = -y_i$, từ $(1)$ suy ra $y_i \bold{x}_i \cdot \bold{w}^\top &gt; 0$, do đó $y’ \bold{x}_i \cdot \bold{w}^\top &lt; 0$.</p>

<p>Ta có hàm $\cos$ của hai vector:</p>

\[\cos(\bold{a}, \bold{b}) =
\frac{\bold{a}\cdot\bold{b}^\top}
{\sqrt{\sum_{i=1}^{k}a_i^2}\sqrt{\sum_{i=1}^{k}b_i^2}}\]

<p>Quay về $(1)$, với vế trái là tích của hai vector $y_i \bold{x}_i$ và $\bold{w}$ là không âm ta có:
\(y_i \bold{x}_i \cdot \bold{w}^\top \geq 0 \Leftrightarrow \cos(y_i \bold{x}_i, \bold{w}) \geq 0 \ \ \ \ \ (2)\)
Vế bên phải cũng tương tự:
\(y' \bold{x}_i \cdot \bold{w}^\top &lt; 0 \Leftrightarrow \cos(y' \bold{x}_i, \bold{w}) &lt; 0 \ \ \ \ \ (3)\)
Gọi $\alpha$ là góc giữa hai vector $y_i\bold{x}_i$ và $\bold{w}$. Theo định nghĩa, góc giữa hai vector nằm trong đoạn $[0\degree,180\degree]$.</p>

<p>Ở (2), $\cos(y_i\bold{x}_i,\bold{w}) \geq 0$, nên:</p>

\[\alpha \in [0\degree,90\degree].\]

<p>Tương tự với (3), nếu góc giữa $y’ \bold{x}_i$ và $\bold{w}$ là $\alpha’$, thì:</p>

\[\alpha' \in (90\degree,180\degree].\]

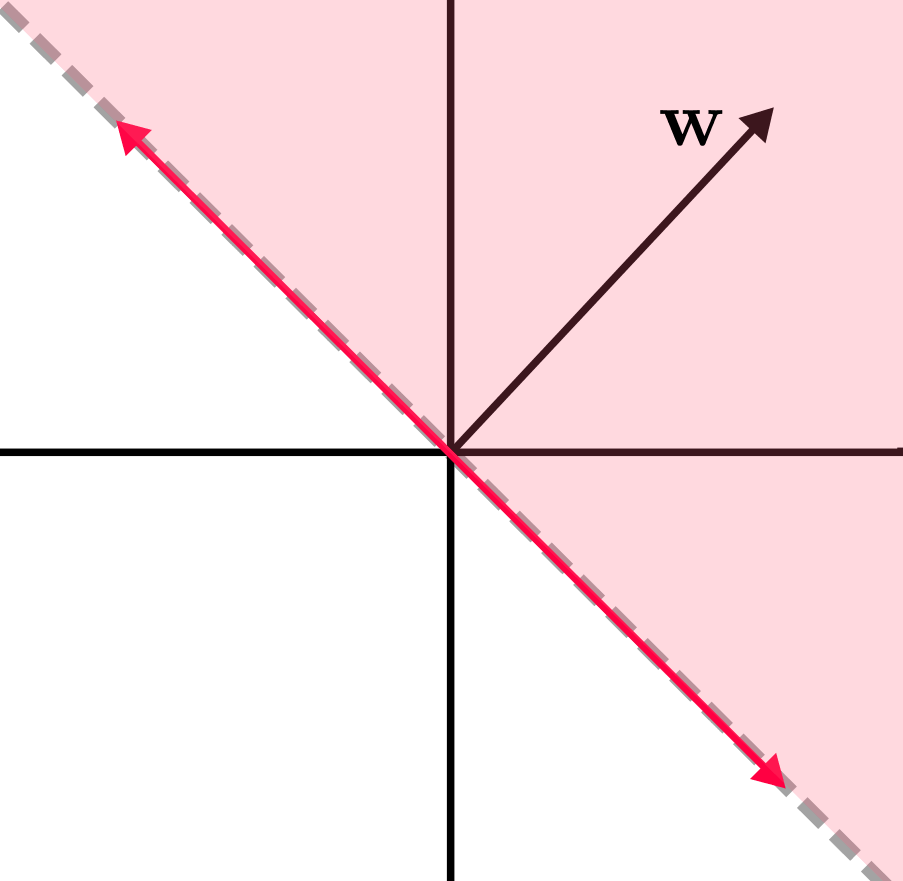
<p>Như vậy các feature vector  $y_i \bold{x}_i$ và  $y’ \bold{x}_i$ phải hợp với $\bold{w}$ một góc lần lượt là $\alpha$ và $\alpha’$, ta hình dung được lãnh thổ của mỗi class:</p>

<p><img src="/essays/images/2019/class-boundary.png" alt="" width="50%" /></p>

<p>$\bold{w}$ vuông góc với biên giới phân lớp. Do đó với mọi vector nằm cùng một phía của biên giới, tích vô hướng của chúng với $\bold{w}$ có cùng dấu và mô hình sẽ dự đoán chúng thuộc cùng một class. Khi vector $\bold{w}$ xoay bao nhiêu thì biên giới cũng xoay bấy nhiêu để đảm bảo chúng vuông góc nhau, đây là câu trả lời tại sao $\bold{w}$ quyết định biên giới phân lớp.</p>

<h3 id="cập-nhật">Cập nhật</h3>

<p>Việc cập nhật sẽ diễn ra khi thuật toán <strong>đoán sai nhãn</strong> của dữ liệu học. Khi phải đoán một điểm dữ liệu, thuật toán không hề biết trước nhãn/lớp của nó, thuật toán sẽ tính nhãn dự đoán từ dấu của $\bold{x}_i \cdot \bold{w}^\top$.</p>

<p>Chúng ta có hai trường hợp phải cập nhật:</p>
<ul>
  <li>Khi nhãn dữ liệu là +1 và đoán thành -1.</li>
  <li>Khi nhãn dữ liệu là -1 và đoán thành +1.</li>
</ul>

<p>Ta sẽ xem xét trường hợp đầu tiên, $y_i = +1$ và $y’ = -1$. Ở phần trên đã đề cập, khi dự đoán đúng nhãn $y_i$:
\(y_i \bold{x}_i \cdot \bold{w}^\top \geq 0 \ \ \ \ \ (4)\)
Vì $y_i = +1$ nên để thỏa (4), thì $\bold{x}_i \cdot \bold{w}^\top \geq 0$. Nhưng vì dự đoán sai nên hiện tại $\bold{x}_i \cdot \bold{w}^\top &lt; 0$, dẫn đến không thỏa $(4)$. Cũng có:</p>

\[\bold{x}_i \cdot \bold{w}^\top &lt; 0
\Leftrightarrow
\alpha \in (90\degree,180\degree].\]

<p>Mục đích cập nhật ở trường hợp này là điều chỉnh lại (\bold{w}) sao cho:</p>

\[\bold{x}_i \cdot \bold{w}^\top \geq 0
\quad hay \quad
\alpha \leq 90\degree.\]

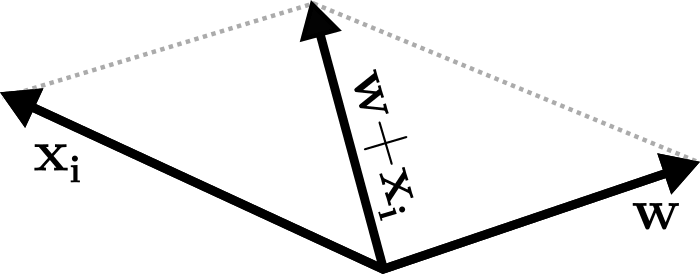
<p>Vậy phải điều chỉnh $\bold{w}$ làm sao để $\alpha \leq 90\degree$? Ta có quy tắc hình bình hành:</p>

<p><img src="/essays/images/2019/update-rotate.png" alt="" width="80%" /></p>

<p>Khi cập nhật $\bold{w} \leftarrow \bold{w} + \bold{x}_i$, ta có $\bold{x}_i \cdot (\bold{w} + \bold{x}_i)^\top = \bold{x}_i \cdot \bold{w}^\top + |\bold{x}_i|^2$. Vì $|\bold{x}_i|^2 &gt; 0$, phép cập nhật làm tăng giá trị $\bold{x}_i \cdot \bold{w}^\top$, tức đưa điểm dữ liệu theo hướng dễ được phân loại đúng hơn. Như vậy công thức cập nhật khi nhãn dữ liệu là +1 và đoán sai thành -1 là:
\(\bold{w} \leftarrow \bold{w} + \bold{x}_i\)</p>

<p>Suy luận tương tự với trường hợp nhãn dữ liệu là -1 và đoán sai thành +1, công thức cập nhật:
\(\bold{w} \leftarrow \bold{w} - \bold{x}_i\)
Ta có công thức cập nhật tổng quát mỗi khi thuật toán đoán sai, với $y_i$ là nhãn chính xác của dữ liệu:
\(\bold{w} \leftarrow \bold{w} + y_i\bold{x}_i\)</p>

<h3 id="thuật-toán">Thuật toán</h3>

<p>Thuật toán được viết gọn như sau:</p>

<p><img src="/essays/images/2019/perceptron-pseudocode.png" alt="" width="70%" /></p>

<p>Với hàm $sgn(x) = 1$ nếu $x \geq 0$ và $sgn(x) = -1$ nếu $x &lt; 0$.</p>

<h3 id="averaged-perceptron">Averaged Perceptron</h3>

<p>Nếu dữ liệu linearly separable, Perceptron sẽ dừng lại một khi tìm được biên giới phân loại chính xác, còn không nó sẽ luẩn quẩn giữa các trọng số mà không hội tụ lại. Một giải pháp cho trường hợp này là lấy trung bình các vector $\bold{w}$ trong quá trình học để thu được một trọng số ổn định hơn. Thông thường thuật toán được chạy trong một số vòng lặp xác định trước, sau đó sử dụng trọng số trung bình để dự đoán. Cách làm này cần thêm chi phí để duy trì trọng số trung bình, nhưng vẫn có thể cài đặt khá hiệu quả.</p>

<p>Một cách khác là ta sử dụng một tập kiểm tra ở ngoài, khi độ chính xác trên tập này bắt đầu giảm, có thể thuật toán đang dần overfit và ta dừng ở đây. Cách làm này gọi là <strong>early stopping</strong>.</p>]]></content><author><name>nhatism</name></author><summary type="html"><![CDATA[Bài viết từ 2019 nên có thể lỗi thời hoặc tác giả chưa đủ chín chắn tại thời điểm đó. Read at your own risk.]]></summary></entry></feed>